
| 일 | 월 | 화 | 수 | 목 | 금 | 토 |
|---|---|---|---|---|---|---|
| 1 | 2 | 3 | ||||
| 4 | 5 | 6 | 7 | 8 | 9 | 10 |
| 11 | 12 | 13 | 14 | 15 | 16 | 17 |
| 18 | 19 | 20 | 21 | 22 | 23 | 24 |
| 25 | 26 | 27 | 28 | 29 | 30 | 31 |
- 자율주행
- TorchServe #Dynamic Batching #SageMaker #Inference
- MLOps #SageMaker #Reinvent2021
- Sagemaker #kubeflow
- Today
- Total
AIML 혼자 공부하기
[AWS-Re:invent 2021] Prepare data for ML with ease, speed, and accuracy (featuring Fidelity) 본문
[AWS-Re:invent 2021] Prepare data for ML with ease, speed, and accuracy (featuring Fidelity)
IniMiniManiMo 2022. 1. 4. 12:28발표자
- Romi Datta, Ph.D. - SageMaker Product Management, AWS
- Kiran Kandala - VP Engineering, ML & Advanced Analytics, Fidelity Investments
원본 영상 : https://www.youtube.com/watch?v=D1jD9WoYU0Y
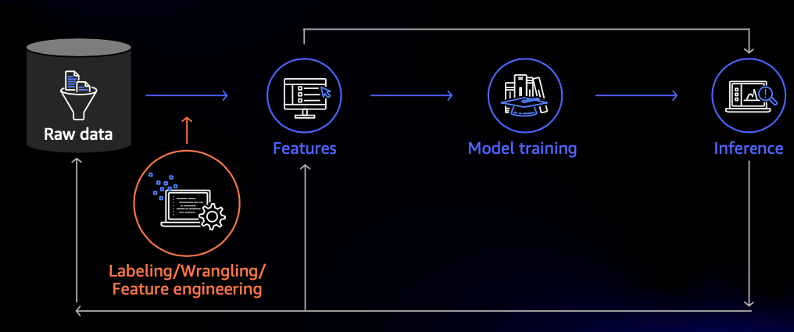
머신 러닝에서 데이터 준비 과정은 가장 힘들 일입니다. 실제 데이터 과학자의 일 중 80% 정도는 데이터를 정제하거나, 데이터셋을 구성하는 일, 데이터를 수집하는 일 등 데이터 준비와 관련된 일이죠. 이에 대해 AWS는 4가지의 데이터 준비과정에서 발생하는 어려움을 나열하였습니다.
- Time-consuming & Resource intensive
- Requires Multiple tools
- Data Preparation tools are typically not DevOps friendly
- Common data preparation tasks require writing code
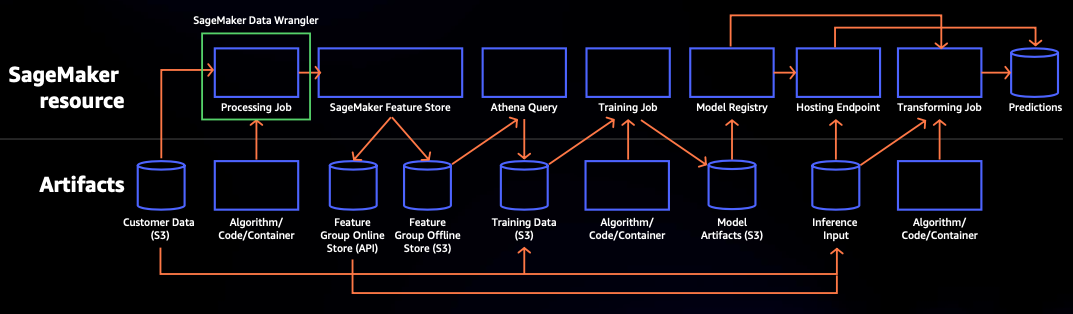
이러한 어려움을 해결하기에 앞서 Amazon SageMaker를 이용하게 되면 다음과 같이 Machine learning의 workflow에서 활용할 수 있는 구성이 가능합니다. 고객의 데이터, 알고리즘, 코드, 데이터의 feature 및 학습된 모델 weights, 인퍼런스 관련 데이터 등을 S3와 SageMaker Feature Store 등으로 저장 및 관리할 수 있으며, SageMaker의 서비스를 통해 Processing, training과 Inference까지의 전체적인 ML Pipeline 구성이 가능합니다.
이 가운데 위 어려움을 해소하기 위해 SageMaker의 Data Wrangler와 Feature Store를 활용할 수 있습니다.
Data Wranlger는 S3와 Athena, Redshift 등에서 데이터를 가져와 EDA (Exploratory Data Analysis)을 위한 Visualization과, 데이터를 학습에 활용할 수 있는 Features로 변환하는 Tool 기능을 제공하며, Data의 workflow를 구성할 수 있는 기능을 함께 제공합니다.
그리고, 이렇게 변환된 Features를 저장할 수 있는 저장소로 Feature Store를 활용할 수 있습니다.
이 세션은 Fidelity에서 활용한 SageMaker의 Feature Store에 대한 내용을 위주로 구성되어 있습니다.
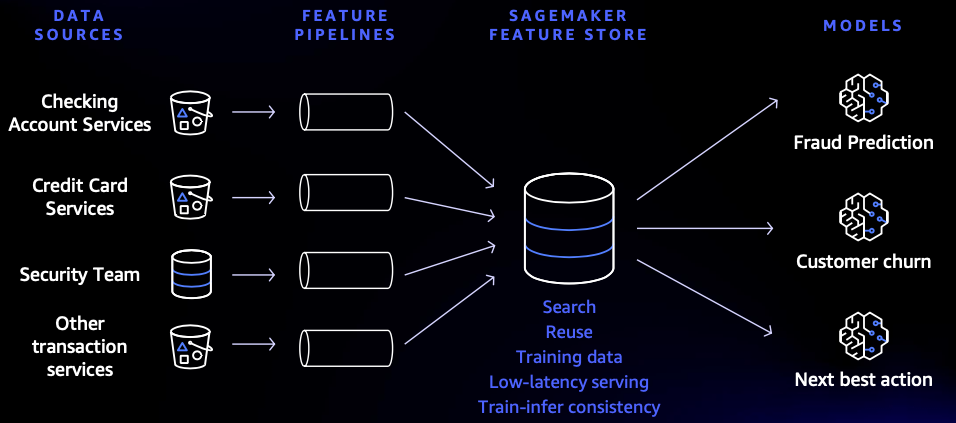
SageMaker Feature Store는 다양한 데이터 소스에서 들어오는 데이터를 일관된 Feature 로 저장할 수 있도록 제공하는 저장소로서 이를 통해 여러 소스의 데이터를 재사용할 수 있도록 하며, 학습과 추론 시 사용하는 데이터의 일관성을 유지할 수 있는 기능을 제공합니다.
실시간으로 추론을 수행하는 경우 실시간으로 들어오는 데이터 소스를 Features로 전환하고, 이를 추론과 동시에 저장해야 하는 일들이 있습니다. 저장을 하는 이유는 향후 이 데이터를 다시 학습 등에 사용할 필요가 있기 때문이죠.
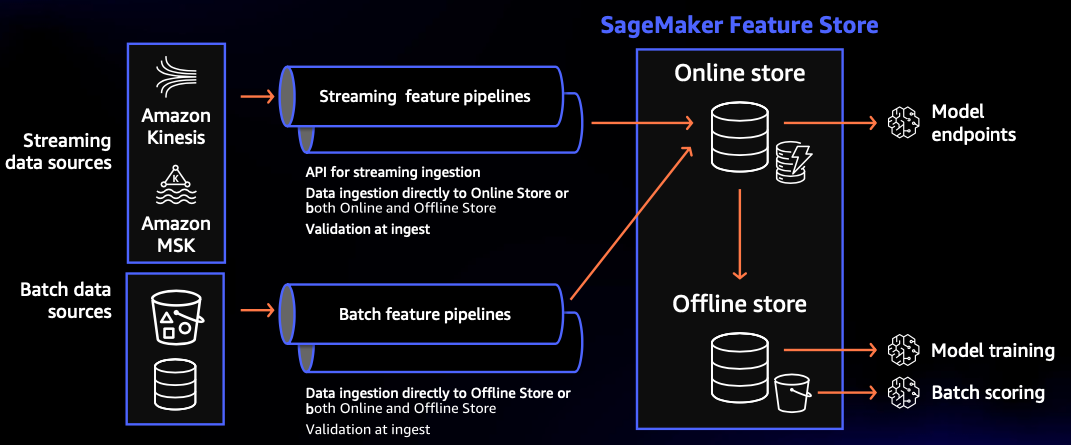
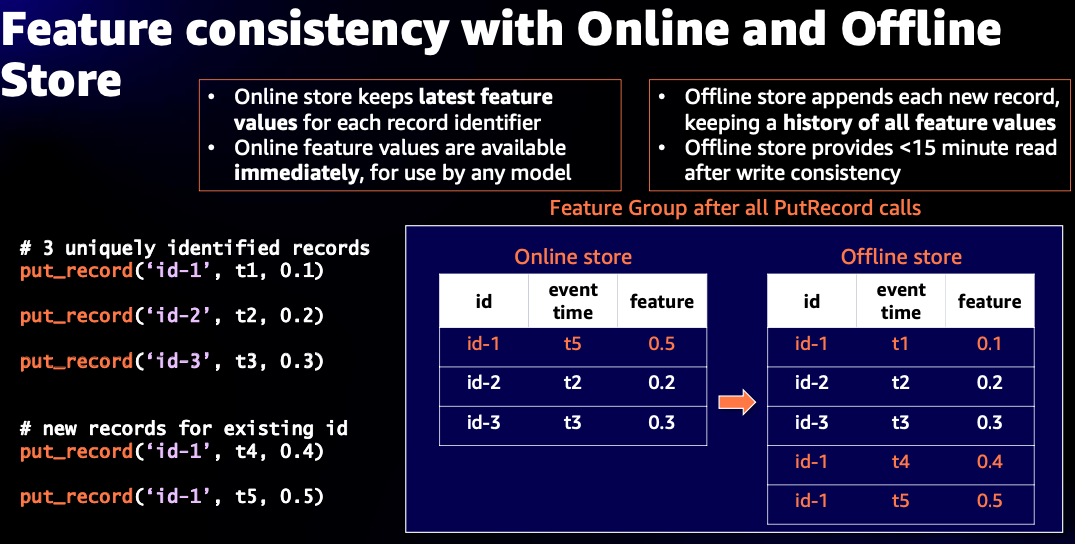
Online Feature Store는 각 record 식별자 별로 최신의 Feature 값을 유지하며, 15KB 페이로드에 대해 10밀리초 미만의 P95 지연 시간을 지원하는 수준으로 필요시 즉시 이 값을 활용할 수 있습니다. Offline Feature Store는 새로운 record를 계속 추가하는 방식이며, 이력 정보를 모두 저장합니다. Offline Feature Store는 write 후에는 일관성 유지를 위해 최대 15분 정도의 시간이 소요됩니다.
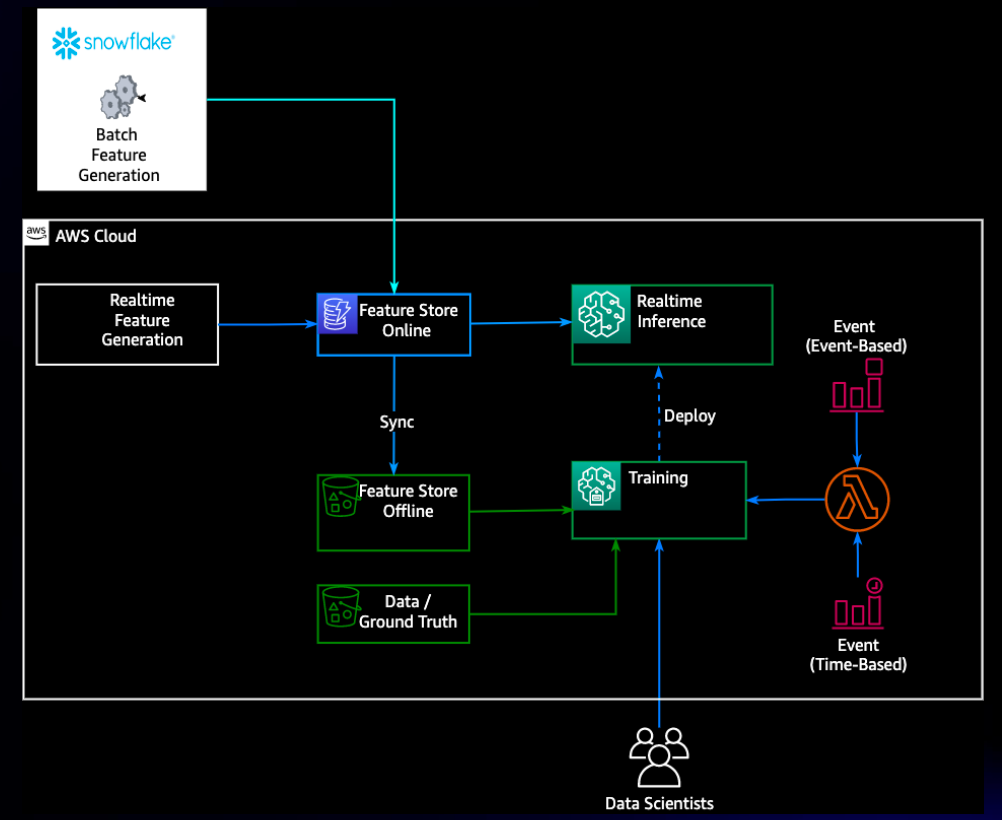
Fidelity Investments에서는 이 세션을 통해 Feature Store를 활용한 Architecture를 공유하고 있습니다.
전체적인 아키텍처는 데이터를 우선 실시간 추론을 위해 Online Feature Store에 저장한 다음 향후 모델 학습에 사용하기 위해 Offline Feature Store에 Sync를 하는 방식으로 사용하고 있습니다.
데이터를 batch로 ingest (put_record)하는 아키텍처를 좀 더 deep 하게 살펴보면,
- 데이터 소스로 부터 각 SA(Subject Area) 별로 데이터를 가져오고, 이 데이터의 메타 정보를 Manifest 파일로 구성합니다. SA는 예를 들어 계좌 (accounts), 잔고 (blances) 또는 거래 (transactions)등이 될 수 있고, 각 SA 별로는 대략 100 개 이상의 feature들이 있습니다.
- SA가 저장된 S3의 위치 정보로 Manifest 파일을 생성한 다음 이를 S3에 저장하면, 저장 이벤트를 통해 SNS와 SQS를 거쳐서 Lambda에서 manifest 파일을 읽습니다.
- Lambda에서는 각 SA별로 이벤트를 생성하여 병렬로 이 작업을 진행하게 됩니다.
- 각 SA 별로 구성된 Queue에서는 Lambda 실행하여 Step functions을 진행하게 됩니다.
- 그림의 1번 스텝과 같이 Step functions는 단계적으로 먼저 FeatureGroup(DB의 테이블 단위와 유사 개념) 을 구성합니다. 요청되는 feature의 스키마와 기존 FeatureGroup의 스키마가 다른 경우 FeatureGroup의 버전은 증가하게 됩니다. Fidelity의 경우는 배치 모드에서 use case별로 대략 17개의 FeatureGroup을 사용하고 있습니다.
- 그림의 2번 스텝에서는 상호 참조되는 ID를 표준화하는 몇가지 전처리 작업에서 Glue 서비스를 통해 진행합니다.
- 다음으로는 SageMaker Processing jobs을 통해 SageMaker는 S3에서 feature 데이터를 읽고, Online Feature Store에 ingest 하게 됩니다.
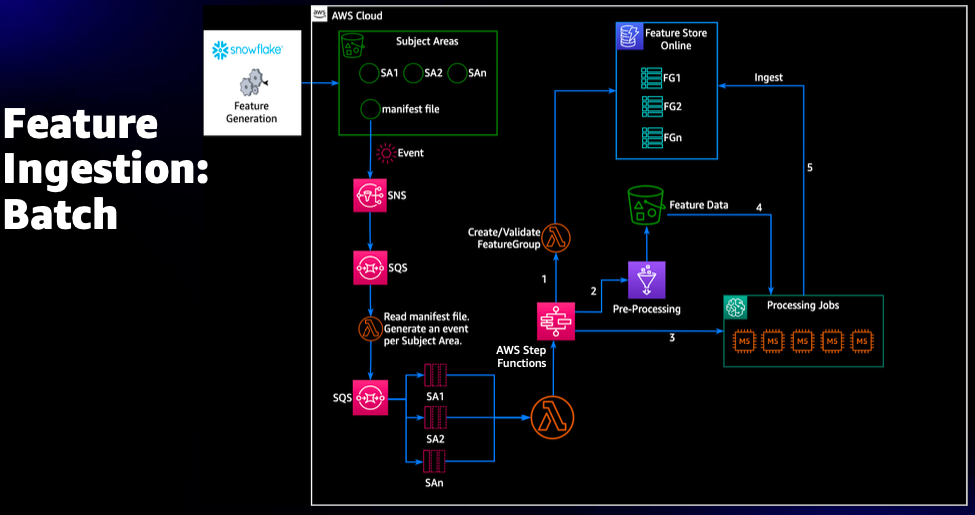
이 아키텍처는 SA별로 이벤트를 발생하고 병렬로 이를 처리할 수 있도록 SQS와 Lambda를 이용한 fan-off pattern을 활용하고 있기에 scalability와 configurability를 제공하고 있습니다.
실시간으로 사용하는 경우 다양한 디지털 채널을 통해 들어오는 데이터 스트림은 수백여개의 feature를 ingest 합니다. 예를 들어 클릭과 같은 스트림 등이 이에 속하게 됩니다. 이런 클릭들은 Kinesis stream을 통해 데이터를 잡아낼 수 있으며, Flink 와 EMR을 사용하여 1시간 단위의 time window에 대해 이 features들을 집계하여 제공합니다. Features들은 클릭 스트림 데이터와 페이지에 임베딩되어 있는 값들을 기반으로 생성됩니다. 이 features들은 이벤트를 통해 SQS로 전달되고, Lambda는 이 이벤트를 읽어서 Feature Store에 업데이트를 합니다. 또한, high throughput과 high performance를 위해 Lambda 사이의 멀티스레딩을 사용할 수 있습니다.

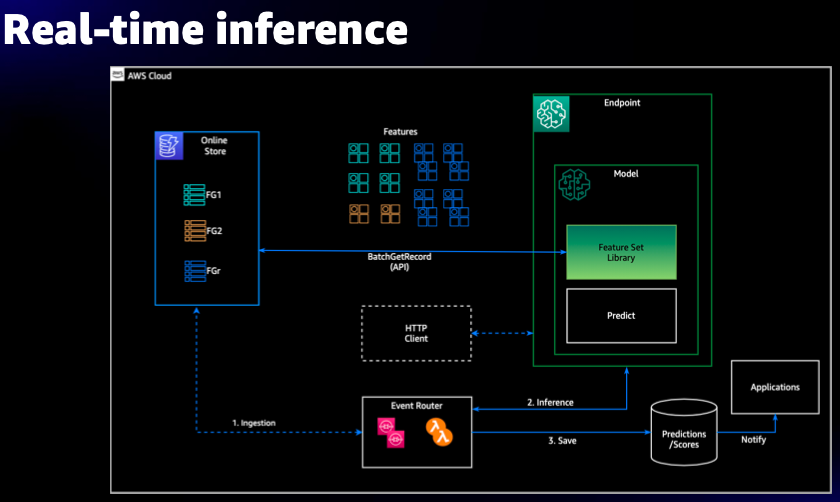
실시간 Ingestion이 완료되면 발생하는 이벤트를 이용하여 SageMaker endpoint에 추론을 요청합니다. 추론 시에 모델에서 특정 구성 파일을 읽을 수 있는 Feature Set Library를 개발하였는데, 구성 파일은 모델이 예측하는데 필요한 관련된 FeatureGroups들과 features들을 매핑하는 정보가 포함되어 있습니다. 이 Feature Set Library는 BatchGetRecord API를 이용하여 각 FeatureGroups 내의 features들을 가져오게 됩니다. 예를 들어 아래 그림과 같이 기존 Batch를 통해 구성된 FeatureGroup 1에서 4개의 features를, FeatureGroup 2에서 2개의 features를 가져오고, Real-time에서 생성된 FGr 에서 8개의 features를 가져올 수 있습니다. Event Router가 SageMaker Endpoint의 예측값을 응답 받으면, Prediction store에 저장하고, donwstream 어플리케이션은 이 결과를 notify로 받아서, 고객의 서비스에 반영하게 됩니다. Fidelity Online의 경우 사용자가 college에 대해 저장하는 옵션을 찾고 있다면, 특정 pipeline이 사용자의 의도를 식별해서 다양한 옵션을 사용자에게 표시할 수 있습니다.
모델 학습에 대해서도 Offline Feature Store를 이용하여 학습에 활용할 수 있습니다.
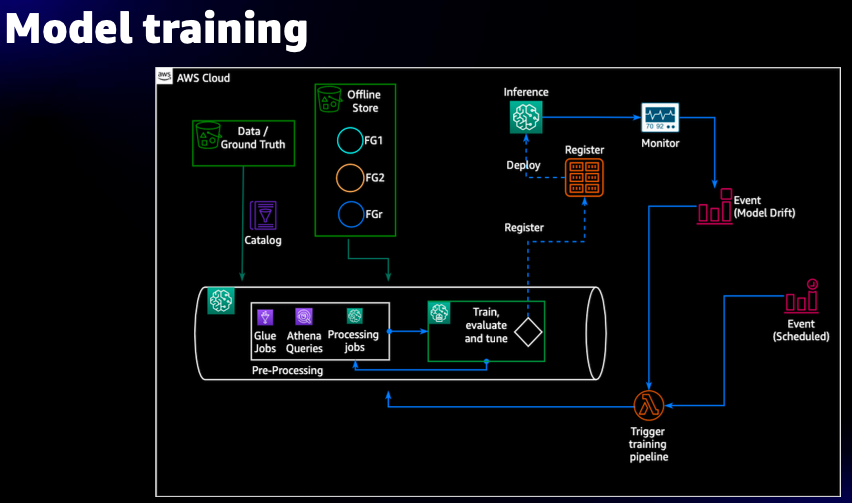
Fidelity는 현재 600 여개의 Subject Areas를 생성하여 사용하고 있으며, batch inference에서 백여개의 모델을 활용하고 있습니다. 향후 이 중 몇개는 real-time 모델들로 배포할 계획이라고 합니다.


