
| 일 | 월 | 화 | 수 | 목 | 금 | 토 |
|---|---|---|---|---|---|---|
| 1 | 2 | 3 | ||||
| 4 | 5 | 6 | 7 | 8 | 9 | 10 |
| 11 | 12 | 13 | 14 | 15 | 16 | 17 |
| 18 | 19 | 20 | 21 | 22 | 23 | 24 |
| 25 | 26 | 27 | 28 | 29 | 30 | 31 |
- TorchServe #Dynamic Batching #SageMaker #Inference
- Sagemaker #kubeflow
- 자율주행
- MLOps #SageMaker #Reinvent2021
- Today
- Total
AIML 혼자 공부하기
[AWS-Re:invent 2021] Implementing MLOps practices with Amazon SageMaker (featuring Vanguard) 본문
[AWS-Re:invent 2021] Implementing MLOps practices with Amazon SageMaker (featuring Vanguard)
IniMiniManiMo 2022. 1. 4. 17:02발표자
- Shelbee Eigenbrode, Principal AI/ML Specialist SA, AWS
- Ritesh Shah, Head of Architecture for Data, Analytics, and Machine Learning, Vanguard
원본 영상 : https://www.youtube.com/watch?v=fuXUi_hoK78
이 세션은 Vanguard에서 Machin Leanring의 MLOps를 구성한 사례를 얘기하고 있습니다.
이를 위해 우선 간단하게 SageMaker에서 활용할 수 있는 기능을 언급합니다. 상단에는 SageMaker native 옵션은 SageMaker의 Projects, Pipelines, Model Registry 등이 있습니다. 그리고 몇 가지 AWS 서비스와 Third-party 등 활용할 수 있는 다양한 사례와 서비스가 있습니다.

그리고,SageMaker의 MLOps-ready Capabilities는 Machine Learning에서의 어려움을 해결하는데 다양한 솔루션을 제공하고 있습니다.
1. Enabling innovation while balancing governance needs
첫번째는 데이터 과학자가 그들이 필요한 리소스를 사용할 수 있는 방법입니다. 컴퓨팅과 스토리지 등의 리소스에 접근하는 모델 개발 환경에 대해 균형 있게 IT 요구사항을 조정해야 합니다.
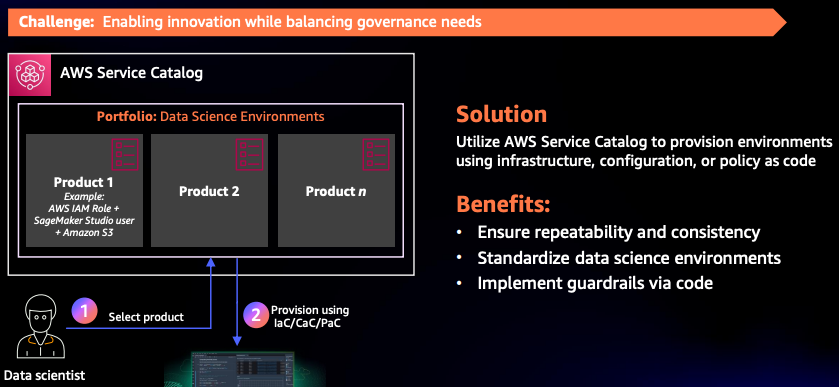
보안, 신뢰성, 컴플라이언스 등을 확실하게 제공하기 위해 MLOps의 구성은 everything-as-code로 제공하는 것이 유리하며, 이럴 경우 코드를 사용하여 모델 개발 활동에 대한 환경을 구성할 수 있습니다. AWS Service Catalog를 사용하게 되면 일정하고 반복적인 매커니즘을 제공하여 코드를 통해 guardraids를 가진 모델 개발 환경을 제공할 수 있습니다.
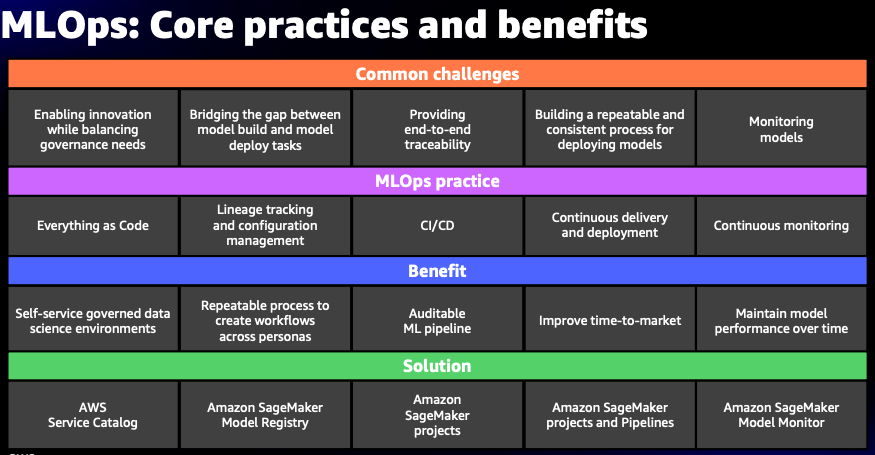
두번째는 모델 개발과 모델 배포 활동 간의 gap을 연결하는 어려움이 있습니다. 일반적으로 모델의 end-to-end의 Lineage를 추적하고 configuration을 관리하는 것으로, SageMaker의 Model Registry를 통해 모델 개발과 모델 배포 간의 간격을 줄일 수 있습니다.
다음으로 어려운 부분은 파이프라인 간의 추적성을 제공하는 것입니다. 이를 위해 CI/CD 개념을 MLOps에 적용해 볼 수 있습니다. MLOps에서는 데이터에 대한 versioning과, 모델 versioning, lineage tracking등의 ML에 좀더 특화된 요구사항을 고려해야 하며, SageMaker Projects는 이를 위해 좋은 솔루션입니다.
또 다른 어려운 부분은 time-to-market을 개선하기 위해 모델의 배포에 대한 반복적이고 일정한 프로세스를 구성하는 것입니다. 여기에는 Amazon SageMaker Projects와 Pipelines을 함께 고려해 볼 수 있습니다.
마지막으로는 Model에 대한 성능을 지속하는 방법입니다. 시간이 지날 수록 모델 성능은 떨어질 수 있으며, 이는 학습에 사용하는 데이터와 현재 데이터의 차이에서 발생합니다. 이를 data drift 또는 concept drift라고 합니다. 모델을 모니터링하는 것은 SageMaker Model Monitor 등을 통해 시스템과 전략을 가져갈 필요가 있습니다.
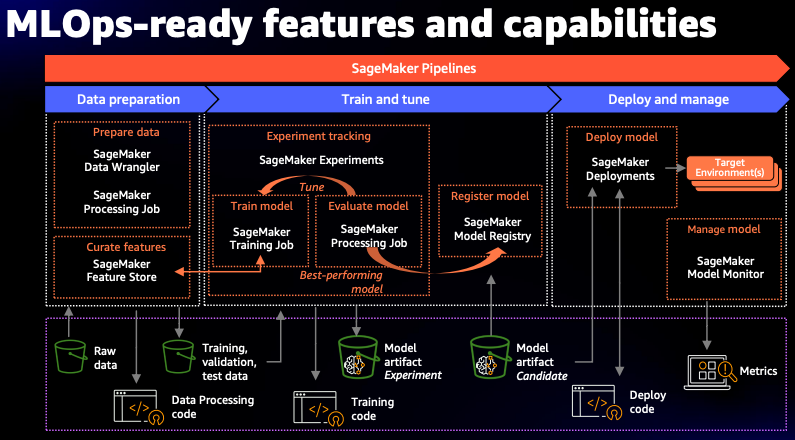
SageMaker가 제공하는 전반적인 MLOps-ready features들을 활용하면 위와 같이 end-to-end의 구성이 가능합니다. 데이터 준비 과정에서 정제와 변환 등 데이터의 workflow는 SageMaker Data Wrangler와 Processing Job을 이용할 수 있습니다. Pipeline의 부분으로 features에 대해 저장할 수 있으며, 이를 Training job에서 활용할 수 있습니다. 실험에 대한 정보는 SageMaker Experiments를 통해 쉽게 저장하거나 활용할 수 있으며, 이를 통해 가장 성능이 좋은 모델에 대한 결과 등을 리스트해서 볼 수 있습니다. 이후 모델을 Model Registry에 등록하게 되면, 모델에 대한 key metadata를 저장하게 됩니다. 이후 KPI에 최대한으로 만족하는 threshold를 가진모델 버전에 대해 모델을 target된 환경으로 배포가 가능합니다. 모델 배포 후에는 Model Monitor를 통해서 concept drift 또는 data drift와 같은 어떤 이슈가 있을 때 알람을 제공할 수 있습니다.
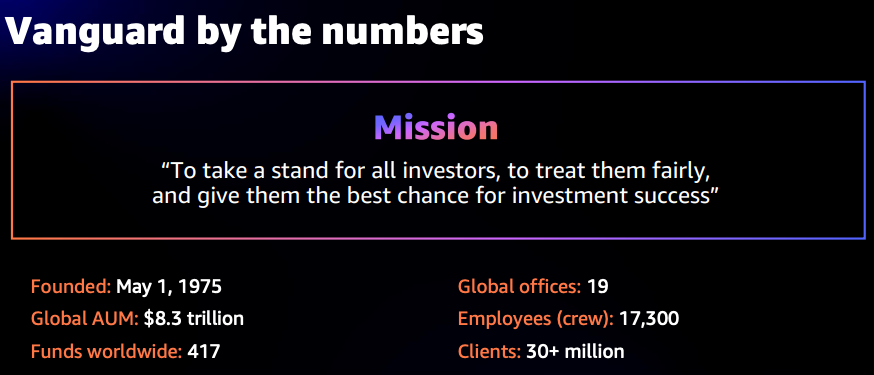
Vanguard는 1975년에 설립된 미국 펜실베니아에 위치한 투자 관리 회사입니다.
Vanguard의 ML 플랫폼을 구성하는 것은 아래 4가지의 목표로 시작을 했습니다.
| Objective | Goal |
| 데이터 과학자들이 사용하는 유용한 플랫폼을 구성하는데 시간을 줄이자 | 24시간 내 그들이 필요한 플랫폼을 제공 |
| 다른 어플리케이션과 서비스들에서 ML 모델을 소비할 수 있는 시간을 최소화하자 | 100% 모델 배포의 자동화 |
| ML을 사용하는데 발생하는 리스크는 최소화하자 | 데이터 과학자나 모델러가 위험을 줄이기 위해 준수해야 하는 모든 컨트롤의 유효성 검사 자동화 |
| 플랫폼 사용에 대한 사용자 만족도를 증가시키자 | 사용자 만족도를 매년 10% 향상 |
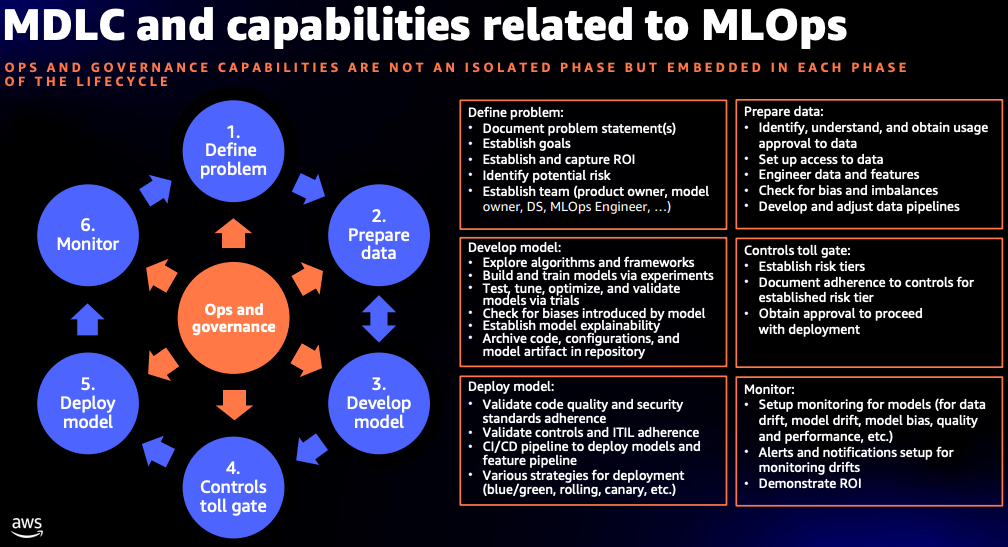
이를 위해 첫번째 단계는 MDLC (Model Development Life Cycle)와 각 단계에서 제공해야 하는 capabilities를 정의하는 것이였습니다.
- Define Problem
- 진행 : 특정 모델에 대한 owner 또는 product owner와 데이터 과학자, ML ops 엔지니어, 그리고 모델 개발에 관련된 다른 페르소나들의 full stack 팀을 구성하면서 문제에 대한 정의를 수행하였습니다.
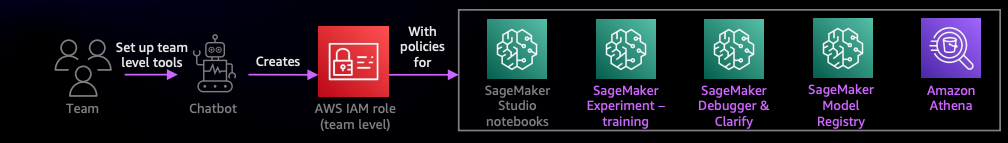
- 구현 : Vanguard에서는 데이터 과학자들과 팀들의 상호 소통을 Chabot 기술을 이용하여 자동화하였습니다. 예를 들어, "나는 새로운 문제가 있어", 또는 "나는 새로운 팀이야" 을 남기면, Chatbot은 직접 IAM role을 셋업하게 되며, 실험, 디버깅 및 Bias와 Explanable한 정보를 얻을 수 있는 SageMaker 기능, Model registry, 필요한 다양한 서비스 등을 포함해서 MLOps capabilities를 제공합니다.
- Prepare data
- 진행 : 다음은 문제를 이해하기 위해 데이터를 준비하는 과정입니다. 내부에는 여러가지 작은 단계가 있는데 데이터를 이해하거나, 데이터를 식별 또는 데이터의 gap을 확인하거나, 모델 개발을 위해 사용할 수 있는 데이터에 접근을 셋업하는 등이 있습니다. Feature Engineering을 하여 모델에 도움이 되는 feature를 구성하였습니다.
- 구현
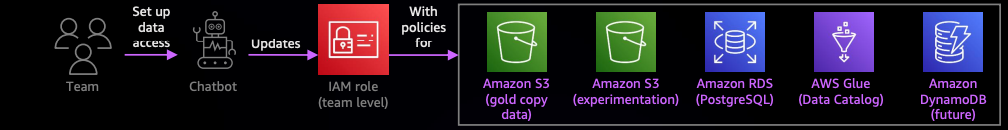
- 앞 단계와 동일하게 Chabot을 통해 데이터 레이크 내 접근이 필요한 S3 bucket의 IAM Role을 자동으로 업데이트합니다.
- 팀은 Chatbot을 통해 SageMaker Studio 내 project 환경을 구성합니다.이 셋업은 CI/CD의 파이프라인의 자동화된 셋업으로 구성됩니다. 이 때 2가지 타입의 코드 저장소를 설정했습니다. 하나는 데이터 과학자들이 개발한 노트북과 학습 스크립트 코드이고, 다른 하나는 ML 엔지니어가 이후 단계에서 Endpoint 또는 batch inferences를 구성하는데 제공할 수 있는 configuration 저장소 입니다.
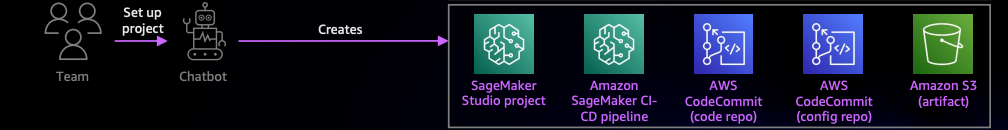
- 마지막으로 다음 단계를 시작할 수 있도록 Project에 대한 최대한의 권한을 해당 Project와 관련된 Team에게 제공합니다.
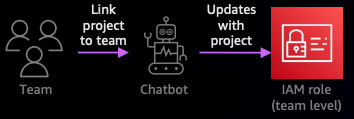
- 앞 단계와 동일하게 Chabot을 통해 데이터 레이크 내 접근이 필요한 S3 bucket의 IAM Role을 자동으로 업데이트합니다.
- Develop model
- 진행 : Prepare data와 모델 개발은 반복적인 프로세스로 진행을 하게 됩니다. 때에 따라 문제를 명확하게 이해하기 위해서는 Define Problem 단계로 돌아가기도 했습니다.
- 구현 : 데이터 과학자는 SageMaker Sutdio Notebook을 사용하고, SageMaker Processing과, EMR 또는 Athena 등의 다른 데이터 처리 스텝을 조율하기 위해 SageMaker Pipeline을 이용합니다. 반복적인 실험에 대해 Experiments 등을 활용할 수 있으며 모든 실험을 완료된 다음, Model Registry에 모델을 등록하게 됩니다. Model Registry에서는 모델을 버전별로 관리하면서 사용할 수 있습니다. 데이터 과학자는 계속해서 학습 스크립트 등을 code 저장소에 push할 수 있습니다. Vanguard에서는 AWS native container 들 보다는 알고리즘을 위해 생성한 container를 가져와서 사용합니다.
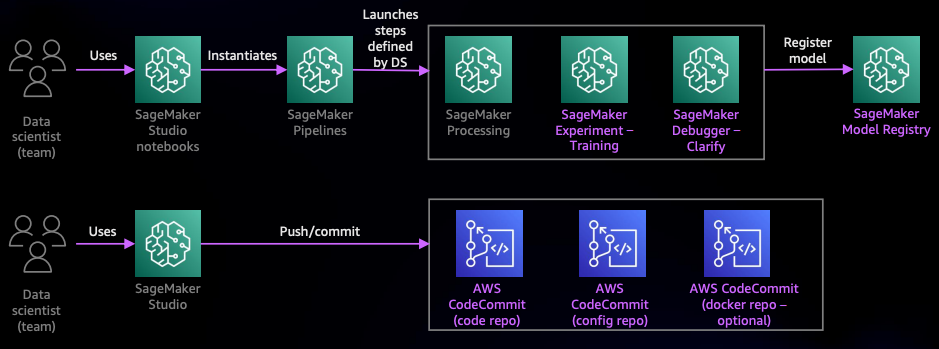
- Controls toll gate
- 진행 : 모델에 대한 risk 정도를 수립하여, risk 분석을 통해 모델이 low risk인지, medium / high/ extremely high risk 인지를 식별합니다. 이 tiers에 대해 모델을 배포할 수 있기 위한 controls을 어떻게 할 것인지를 구성하였습니다.
- 구현: 모델의 owner는 Chatbot을 통해 모델을 을 개발하는 다양한 관점에서 질문에 답변하게 됩니다. 이 질문은 모델의 owner가 모델의 risk tier를 결정하느데 도움을 줍니다. Chatbot은 이를 기반으로 risk tier를 자동으로 선택하고, 생성한 SageMaker project와 Model Registry, Model에 risk tier를 tag 합니다. 전체 questionnaire는 대답에 대한 분석을 위해 S3에 저장합니다.
- Deploy model
- 진행 : 코드를 검증하고, 코드가 조직 내 보안 규정에 만족해야 했으며, 코드는 사람이 배포하기 보다는 CI/CD 파이프라인을 이용하여 배포하였습니다.
- 구현: 모델에 대한 승인이 되면, CI/CD 파이프라인을 통해 자동으로 실행이 되며, 코드에 대한 보안 취약성, 코드의 품질 점검, risk tier 별 제어 확인 후에 컨테이너로 ECR에 배포하게 됩니다. production의 변경 record는 ServiceNow에 추가하고, 모델을 배포한 다음, 모엘 모니터링을 셋업합니다.
- Monitor
- 진행: 파이프라인의 일부로서, 어떤 이상 또는 drift 또는 bias가 감지될 수 있도록 모델의 모니터링을 구성하고자 하였습니다.
- 구현 : Vanguard는 data drift, model quality, bias drift, feature drift 에 대해 모델 모니터링을 사용하였습니다.
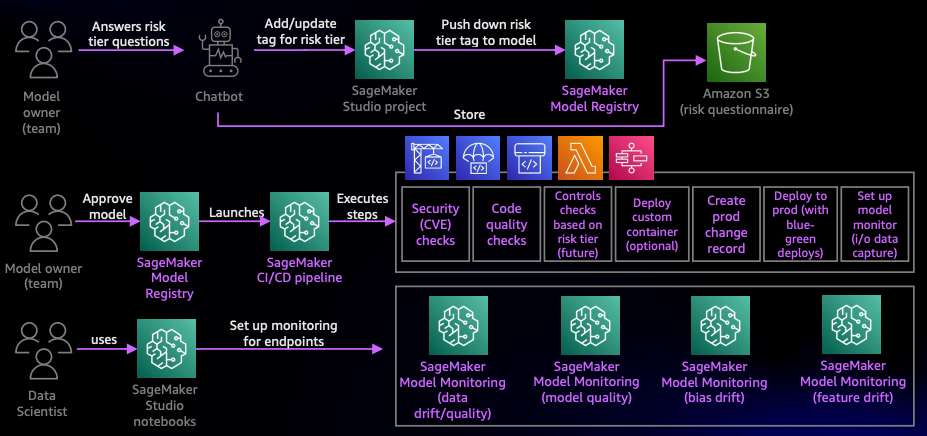
SageMaker는 이를 구현하기 위해 많은 부분에 걸쳐 capabilities를 제공하고 있기에, 효과적으로 MLOps를 구성하는데 도움이 많이 됩니다. 이후 Vanguard는 Feature Store를 개선하는 부분과 Feature 관리에 대한 custom CI/CD 파이프라인을 구성하는 영역으로 확장할 계획입니다. 그리고 모니터링에 대해 endpoint외에도 batch로 확장하고, endpoint의 모니터링을 메모리/ CPU / GPU 사용량 관점에 대해 운영적인 healthness까지 고려할 계획이라고 합니다.


