| 일 | 월 | 화 | 수 | 목 | 금 | 토 |
|---|---|---|---|---|---|---|
| 1 | 2 | 3 | ||||
| 4 | 5 | 6 | 7 | 8 | 9 | 10 |
| 11 | 12 | 13 | 14 | 15 | 16 | 17 |
| 18 | 19 | 20 | 21 | 22 | 23 | 24 |
| 25 | 26 | 27 | 28 | 29 | 30 | 31 |
- Sagemaker #kubeflow
- 자율주행
- TorchServe #Dynamic Batching #SageMaker #Inference
- MLOps #SageMaker #Reinvent2021
- Today
- Total
AIML 혼자 공부하기
[AWS-Re:invent 2021] Qualtrics 사에서 SageMaker 기반 MLOps 구현기 소개 본문
[AWS-Re:invent 2021] Qualtrics 사에서 SageMaker 기반 MLOps 구현기 소개
IniMiniManiMo 2022. 1. 5. 15:12원본발표제목 : Use SageMaker to develop ML models faster (featuring Qualtrics)
발표자
- Dr. Ali Arsanjani, AI/ML Specialist SA, AWS
- Samir Joshi, ML Engineer, IQ R&D, Qualtrics
원본 영상 : https://www.youtube.com/watch?v=G9dwSJHwprU
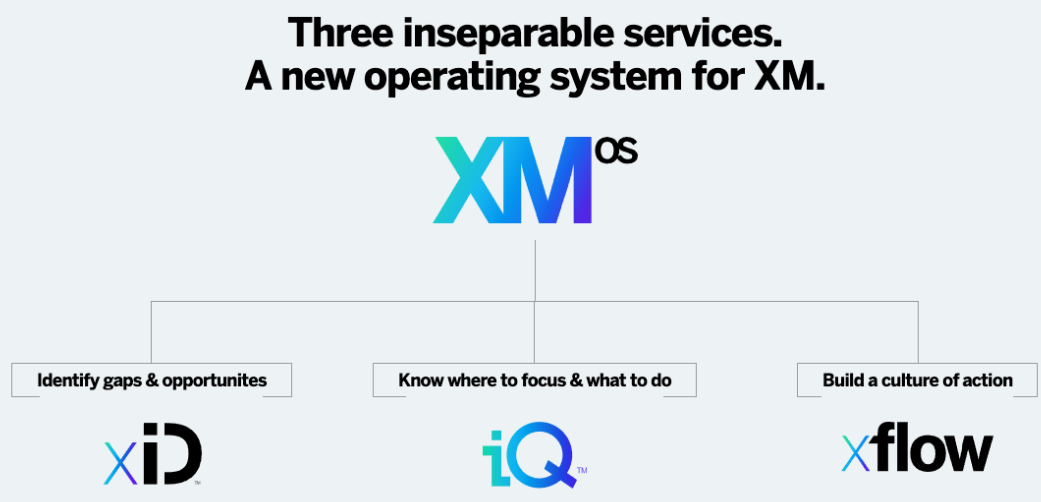
Qualtrics는 미국의 Experience Management 회사입니다. 고객, 임직원, 브랜드와 제품의 experience gap을 가깝게 하는데 도움을 주는 기술을 개발하며, XMOS (Experience Operating System) 을 통해 gap을 식별하고, 집중해야 하는 것과 해야 할 일을 알게 되며, 궁극적으로는 다양한 활동을 통해 문화를 만들게 됩니다.
Qualtrics는 이러한 일들에 Natural Language Processing, tabular 데이터에 대한 Predictive model, time-series prediction 등을 포함해서 몇 가지 ML use case들이 있습니다. NLP이 경우, 고객들이 experience를 더 잘 관리할 수 있도록 활동적인 인사이트를 제공하기 위해 수억 개의 예측 규모로 large-scale ML을 사용하고 있습니다. Tabular 데이터셋으로는 churn 예측, 분류 등을 포함해서 특정 브랜드와 고객의 데이터에 특화된 customer specific한 모델들을 개발하고 있습니다. time-series 예측과 anomaly detection에 대해서는 gap을 식별하고, 고객의 패턴을 예측하는 데 활용하고 있습니다.
Qualtrics는 이런 ML 작업을 위해 SageMaker 기반으로 구성된 Qualtrics ML Platform에서 labeling 등의 데이터 준비와 학습 및 모델 배포 과정을 수행하고 있으며, SageMaker의 Ground Truth와 Real-time Inference, Batch Transform 등을 활용합니다.
우선적으로 Qualtrics은 ML 워크로드를 수행하는데 있어서 몇가지 어려움들이 있었습니다. 이를 universal model들과 customer-specific model들로 나누어서 생각해보면 아래와 같습니다.
- Challenges Encountered – Universal Models
- NLP에 사용되는 다수의 언어 모델들은 GPU를 사용하는 large-scale deep learning 모델로 복잡하고, 비용적인 부담이 발생하게 되는데, 특히 Qualtrics의 인프라는 on-premise와 AWS를 함께 사용하는 하이브리드 클라우드 환경을 사용하고 있음
- ML워크로드에 활용하는 툴들이 제각각이고, 데이터 탐색, 분석이나 온 디멘드 기반 학습 등이 어려운 제한적인 개발 환경임
- 규모에 따라 유연하게 제공하는 레이블링 툴이 없음
- Challenges Encountered – Customer-Specific Models
- 고객들은 자신의 데이터와 학습 모델 등 자신들의 리소스가 다른 사람들이 활용되는 것을 원치 않기에 ML 라이프사이클의 각 단계는 고객 리소스에 대해 완벽하게 격리된 환경을 보장하는 워크플로우가 필요
- 수십, 수백, 수천 개의 모델이 구축된 다음, 고객은 각각 다른 방식으로 모델과 예측 결과에 접근하기에 다양한 로드 패턴으로 배포되고 호출하는 방법이 필요
다음 단계로 진행하기 전 SageMaker에서는 제공하는 일반적인 ML Reference Architecture를 잠깐 살펴보면 아래와 같습니다.
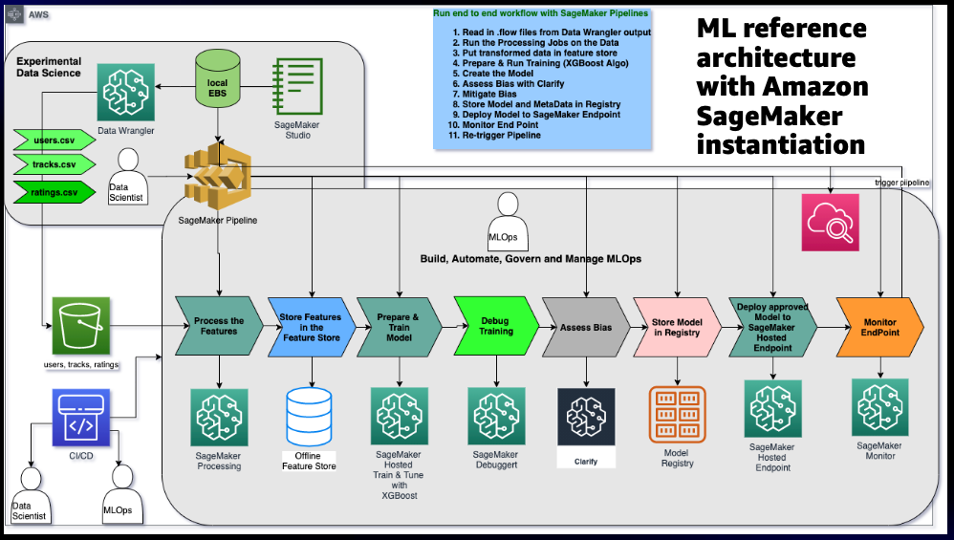
초기 단계에서는 데이터를 수집하고, 정제한 다음, 변환에 대해 정의를 한 후, 전처리를 거쳐서 Feature Store에 저장하게 됩니다. 다음 모델을 학습하면서 디버깅을하고, 데이터 셋 내 bias를 평가한 후, 이를 완화하고, 경우에 따라 모델 내의 bias도 평가하고 완화하는 작업을 합니다. 메트릭과 bias 관점에서 학습된 모델이 적합한 경우 이를 Model Registry에 등록합니다. 이후 모델을 선택할 수 있으며, 다양한 방식으로 모델을 배포할 수 있습니다. real-time endpoint 나 batch transform으로 제공이 가능하거나, async 방식으로 인퍼런스 수행도 가능합니다. SageMaker Monitor는 data drift또는 concept drift를 탐지하기 위해 endpoints를 모니터할 수 있고, 새로운 데이터 또는 새로운 모델 개발이 필요한 경우 Pipeline을 재시행이 가능합니다. 추가적인 요소는 코드 변경 시에 필요한 CICD 파이프라인도 구성할 수 있습니다.
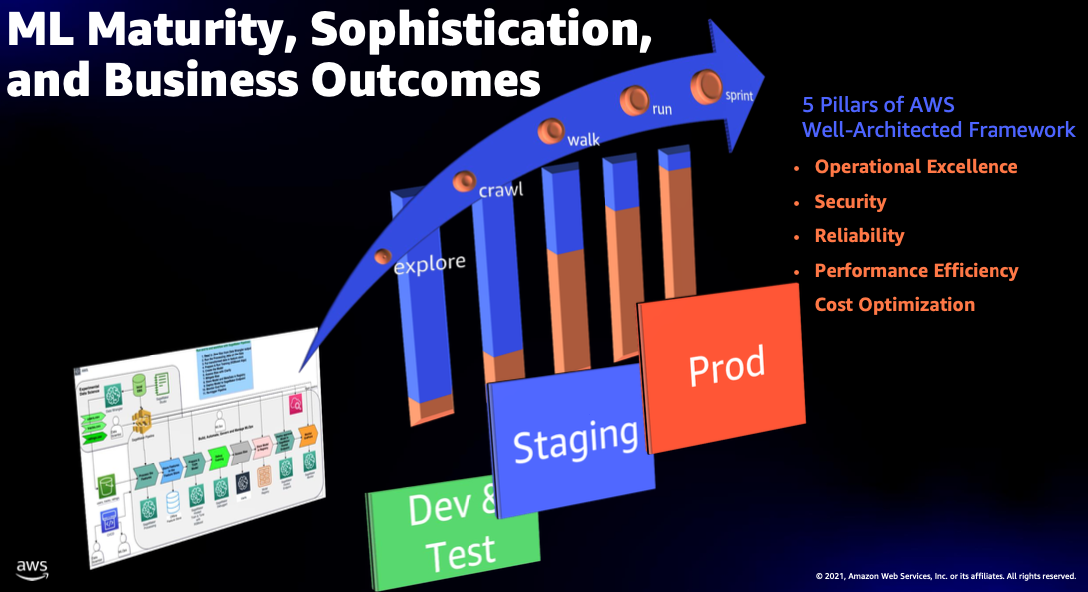
조직은 다양한 어려움 부분을 해결하면서 원하는 ML Platform을 구축하기 위해 성숙도의 첫번째 단계부터 다른 단계로 가기 위해 다양한 시도와 고난, 성장통을 겪게 되었습니다. Exploring을 시작으로 Crawl, Walk, Run, Sprint로 진행되는 시간에 따라 조직의 역량과 정교함, 그리고 투자에 대한 수익이 점차 증가하게 됩니다. 이런 과정에서 well-architected framework의 5가지 pillars를 생각하면서 구성하는 것도 필요합니다. 초기 단계에서 모든 Pillar를 만족할 필요는 없습니다. 하지만, Sprint 단계에서는 각각의 Pillar가 만족스럽게 가져갈 경우에 scale을 하더라도 시스템에 대한 저하를 고민하지 않을 수 있습니다. 또한, 개발/테스트, 스테이징, Production 환경의 분리도 고려해야 합니다. Explore에서 Sprint에 이르기까지 성숙도의 여러 단계를 거치면서 개발 및 테스트, 스테이징 및 Production과 같은 여러 환경에서 이러한 작업을 수행해야 합니다. 성숙도 Curve가 올라갈 수록 이런 부분은 더욱 필요하게 되며, 환경에 대한 5개 Pillar의 성숙도도 높아져야 합니다.
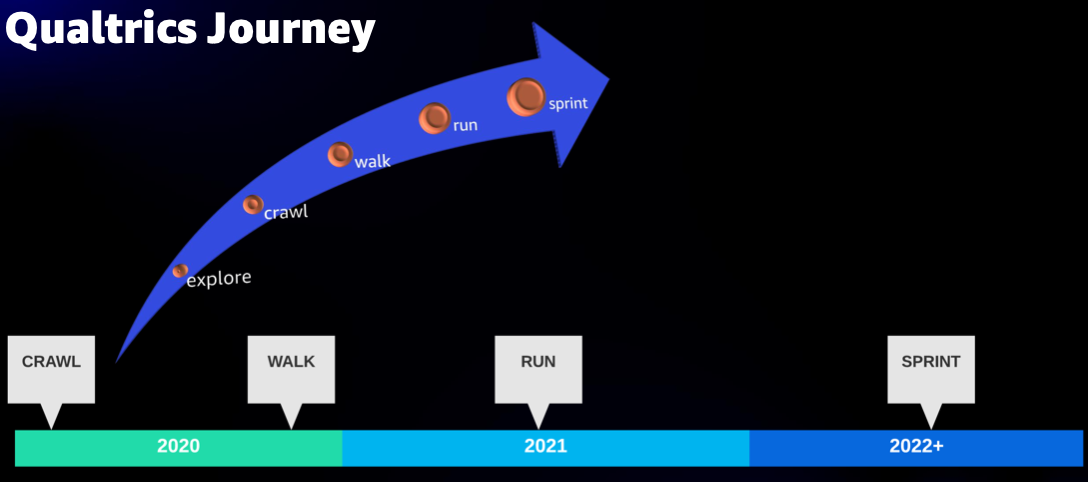
Qualtrics은 성숙도 단계를 아래 일정으로 진행하고 있습니다. 현재는 Crawl과 Walk를 거쳐서 Run 단계이며, 많은 ML 시스템들에 대해 Sprint 단계를 앞두고 있습니다.
- Crawl : 우선 Qualtrics 내부 인프라에서 CPU 인스턴스로 작은 모델을 production에서 운영하는 것입니다. 이 단계에서는 2가지 어려운 점이 있었습니다.
- Scalability : 필요한 throughput을 제공하는 GPU 또는 accelerator 인스턴스가 내부적으로 부족하고, 또한 예측을 위해 더욱 크고, 고품질의 모델을 배포하는 것도 어려웠음
- Time to launch : 데이터 탐색과 학습을 위한 환경이 부족하여, 모델 개발과 이를 상용화하는데 더딘 상황이였음
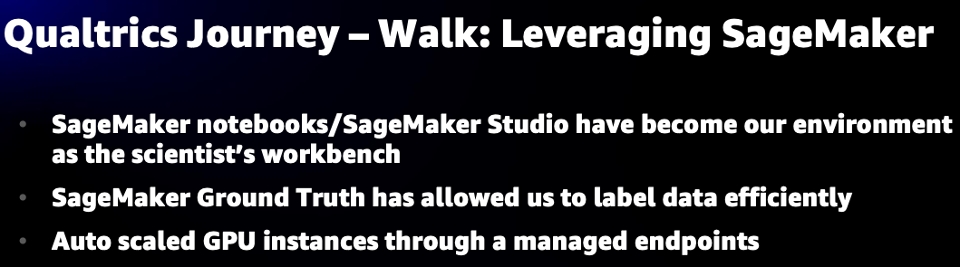
- Walk : SageMaker를 적용하는 관점에 집중하면서, 첫 단계로 AWS SageMaker에서 모델들을 배포하였고, SageMaker 노트북과 Training job, Hyperparameter Optimization 등 학습과 데이터 분석 작업을 수행하였습니다.
- 고객에게 필요한 throughput에 도달하기 위해 managed endpoints를 통해 auto-scaling GPU가 가능한 SageMaker의 real-time inference로 모델을 배포
- SageMaker 노트북과 SageMaker Studio를 데이터 과학자들의 환경으로 제공
- SageMaker Ground Truth로 데이터에 효율적으로 레이블링 할 수 있으며, 가장 중요한 것은 데이터가 저장되는 환경과 동일한 환경에 두는 것이 가능
- Experimentation Platform으로 더 나은 모델 metrics 추적과 서로 간의 모델 벤치마크, 그리고 상용화를 위한 모델 승인 등 제공
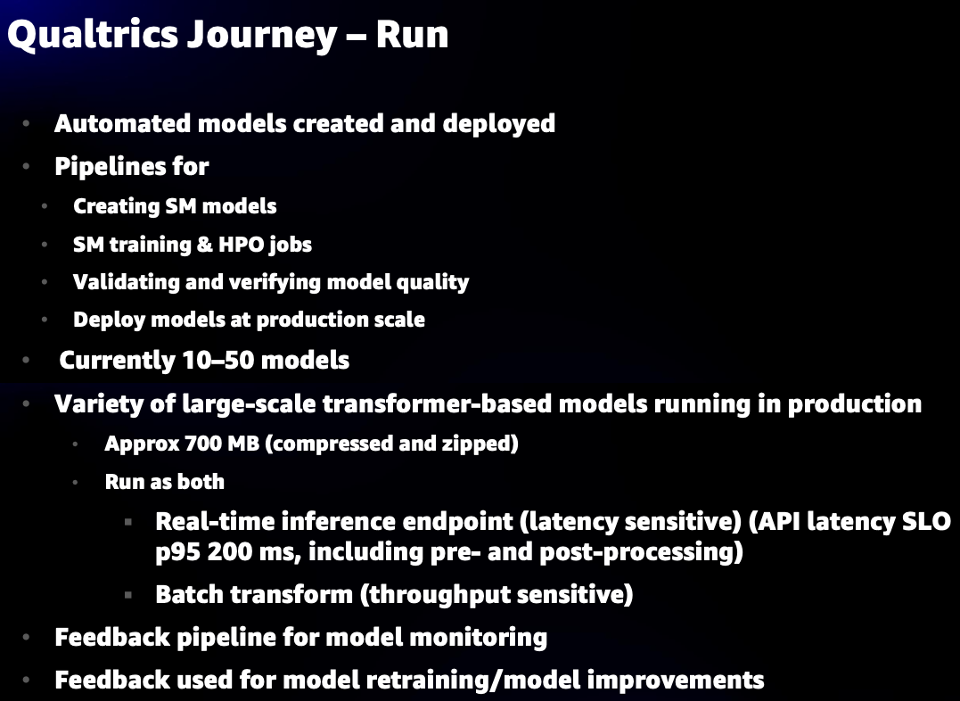
- Run : 2021년과 올해 초로 넘어가면서 Experimentation Platform에서 모델 생성, SageMaker training과 Hyperparameter Optimization, 모델 검증, production 규모로의 모델 배포 등을 위한 파이프라인을 통해 자동화되는 대규모 ML 시스템을 제공
- 모델은 작은 customer-specific model들에서 부터 큰 규모의 universal 모델까지 다양한 크기로 고객들에게 모두 서빙이 됨
- 현재 10 ~ 50개 모델을 배포하고 향후 수백에서 수천개로 확장할 계획임
- Universal 모델에 대해 상용화로 다양한 large-scale transformer 기반 모델을 배포해서 사용 중
- 대략적인 크기로 압축 시 약 700MB 이며, Latency가 중요한 경우 실시간 inference endpoint를, Throughput이 중요한 경우 Batch transform을 사용 (둘 다 동일 code을 사용)
- 고객들을 위해 모델을 지속적으로 개선하기 위해 Model Monitoring과 Model retraining 등의 Feedback Pipeline을 개발
-
- SageMaker는 수백 개의 독립적인 모델들에 대해 HPO, Training jobs, Batch Transformation, real-tim inference는 수평적으로 확장 가능
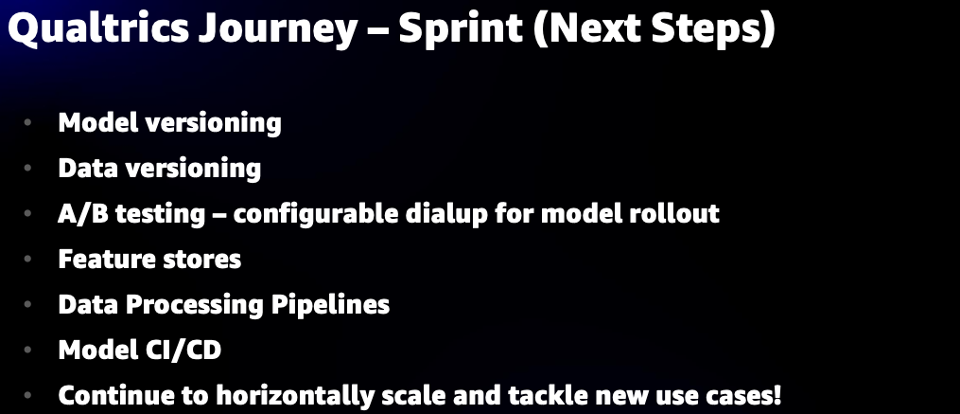
- Sprint : 향후 SageMaker를 이용하여 다양한 서비스를 적용할 계획임
Qualtrics가 SageMaker를 사용한 이유는 2020년 부터 사용하면서, SageMaker는 ML 라이프사이클의 모든 분야를 다루고 있으며, AWS의 다른 서비스를 활용할 수 있도록 잘 통합되어 제공하고 있습니다. 새로운 use case를 제공할 수 있는 새로운 features를 계속 제공하여 충분히 활용 가능하고 확장이 가능합니다. 또한 SageMaker와 통합하는데 중요한 것은 AWS Team 과의 파트너십과 commitment 입니다.