| 일 | 월 | 화 | 수 | 목 | 금 | 토 |
|---|---|---|---|---|---|---|
| 1 | 2 | 3 | ||||
| 4 | 5 | 6 | 7 | 8 | 9 | 10 |
| 11 | 12 | 13 | 14 | 15 | 16 | 17 |
| 18 | 19 | 20 | 21 | 22 | 23 | 24 |
| 25 | 26 | 27 | 28 | 29 | 30 | 31 |
- 자율주행
- Sagemaker #kubeflow
- MLOps #SageMaker #Reinvent2021
- TorchServe #Dynamic Batching #SageMaker #Inference
- Today
- Total
AIML 혼자 공부하기
[AWS-Re:invent 2021] Aurora 사에서 자율주행을 위한 SageMaker와 kubeflow 활용 사례 본문
[AWS-Re:invent 2021] Aurora 사에서 자율주행을 위한 SageMaker와 kubeflow 활용 사례
IniMiniManiMo 2022. 1. 5. 22:00원본 발표 제목 : Train ML models at scale with Amazon SageMaker (featuring Aurora)
발표자
- Emily Webber, Senior ML Specialist SA, AWS
- Yu Guo, Senior Manager of Perception, Aurora
원본 영상 : https://www.youtube.com/watch?v=XKLIhIeDSCY
Aurora 는 자율주행을 개발하는 회사로서 안전하고, 빠르며, 광범위한 자율주행의 장점을 고객들에게 제공하는 것을 미션으로 합니다. 현재 개발한 Aurora Driver는 사람을 이동시키는 세단에서 부터 물건을 이동하는 트럭에 까지 모든 것을 작옫하기 위해 고안된 자율주행 시스템 입니다. Aurora는 교통 네트워크와 자동차 제조사들과 파트너십을 통해 전 세계에 자율주행의 장점을 제공하고 있습니다.
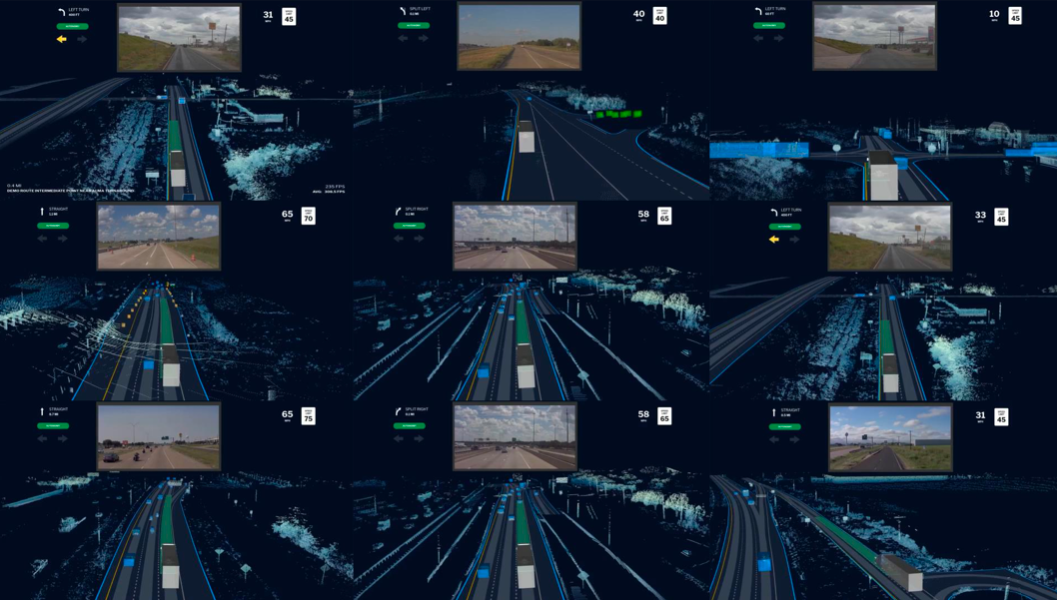
Aurora Perception 팀은 수백 미터를 내다볼 수 있는 라이다와 같은 기반 기술들에 투자하고 있으며, 더욱 안전하고 효과적으로 개발할 수 있는 오프라인 시뮬레이션으로 시스템을 검증하고, 도로에서의 안정성을 확신할 수 있는 충분한 데이터를 제공합니다. Aurora Driver는 주변 환경을 이해하고, 다른 actors에 대해 추론하며, 적절한 행동 경로를 결정하고, 안전한 방법으로 action을 실행하게 합니다. 딥 러닝 기반의 자체 Perception 시스템은 주변 환경을 잘 이해하고 실제 시나리오에서 정확한 의사결정을 가능하게 합니다. Dallas와 Houston 사이 도로에서 자율주행 기술을 개선한 후, 새로운 Aurora Driver 베타를 출시하여 FedEx와 함께 상업적인 용도로 활용해 가고 있습니다.
Aurora Driver 베타는 업그레이드된 하드웨어와 자율주행 시스템을 트럭들이 고속도로와 서비스 거리를 안전하게 주행할 수 있도록 하는 핵심 기능을 제공합니다. Aurora 의 Perception 스택은 3개 task의 딥러닝 엔진으로 구성되어 있는데, Sensor to Tensor, Sensor to Adjustment, RemEx 입니다.
- Sensor to Tensor : 라이더, 레이더, 카메라를 통한 detection 엔진
- Sensor to Adjustment : recurrence tracker
- RemEx (Remainder explainer) : 운전자가 주의해야 하는 환경에 대한 모든 정보를 지원
이 기능은 object persistence engine과 결합되어 운전자에게 끊임없이 장면을 이해할 수 있도록 합니다. 예를 들어, Perception 시스템의 한 부분인 Sensor to Tensor는 다중의 센서 모달리티에서 추론과 학습을 위해 센서 퓨전을 사용하는 딥 러닝 Detection 모듈로 Aurora Driver를 둘러싼 세계에 대한 깊은 이해를 생성합니다. 최신의 초기 sensor fusion 접근은 다양한 센서들의 모달리티를 통한 보완적인 강점을 유지하고, 지도 정보와 함께 다양한 센서들의 모달리티를 전체 3D와 먼거리 범위 내에서 보행자, 차량, 자전거 이용자 등과 같은 actors를 고품질 detection이 가능한 common view로 점진적으로 융합합니다.

센서 융합(fusion)의 가장 큰 어려움은 다른 센서들이 world에 대해 각각 다른 resolution과 view를 가지고 있다는 점입니다. Sensor to Tensor는 점진적으로 world에 대한 다양한 센서 view에서 정보를 점진적으로 추출하고 저장하여, 소위 Euclidean Tensor view라는 common 3D representation을 가져 오며, 라이다, 레이더 이미지, 맵 정보를 통합하여, world에 대해 추론을 할 수 있습니다. 따라서, raw 데이터 입력만으로 얻은 결과는 Euclidean view, Range view, Camera image의 세가지 view에서 상호 보완적인 센서 데이터를 얻을 수 있습니다. 각 View는 유용한 정보를 가지고 있으며, 궁극적으로 Aurora Driver 주변 환경을 전체적으로 representation하는데 기여할 수 있습니다.
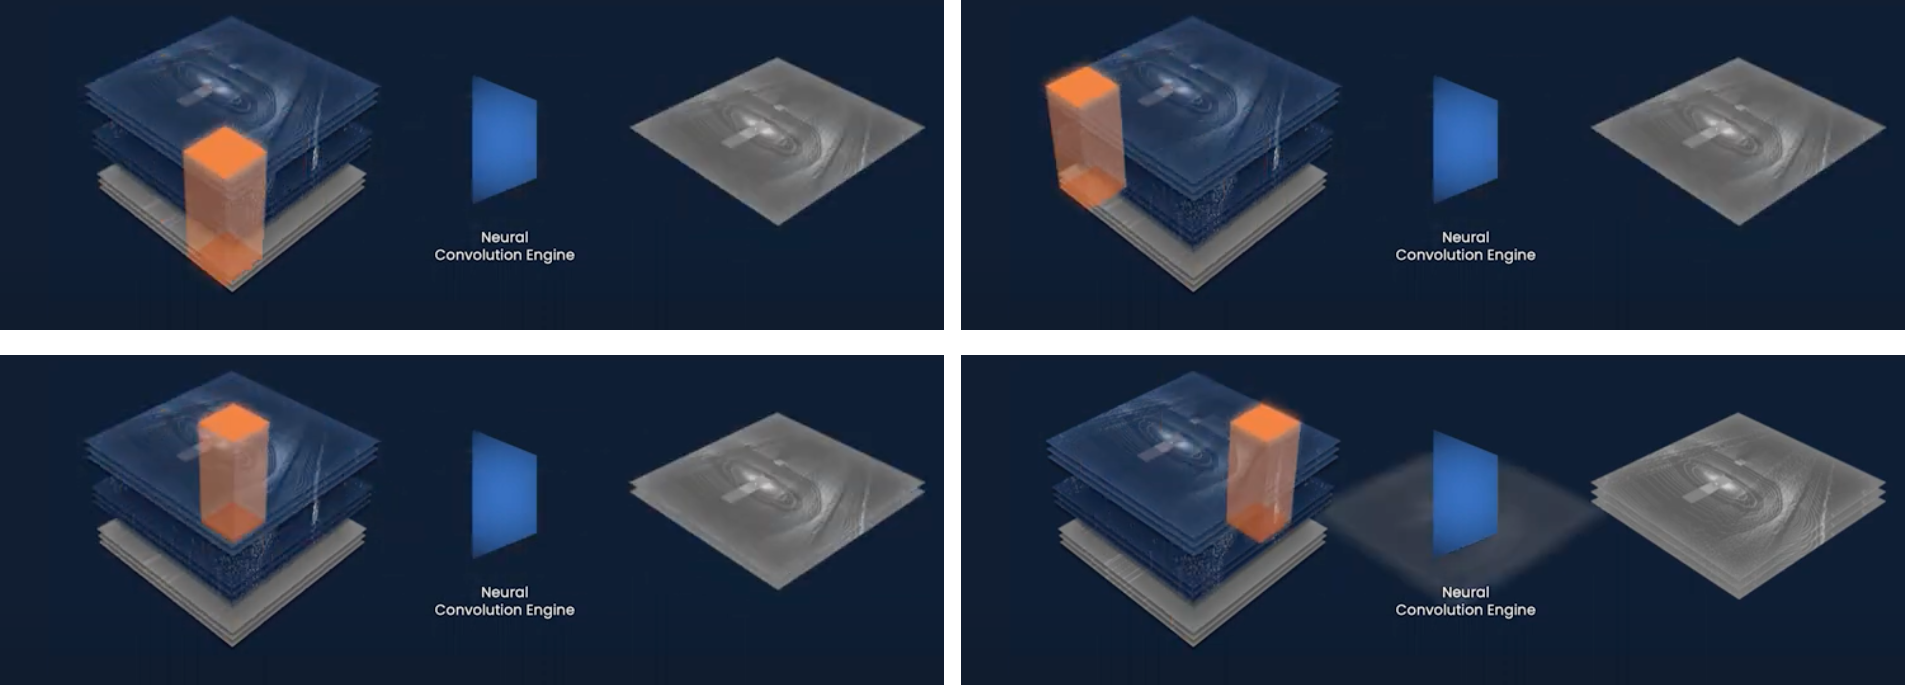
각 view에서 가치있는 정보를 추출하기 위해 Neural Convolution 엔진은 들어오는 센서 데이터를 처리하게 되고, Aurora Driver 주변의 world를 애니메이션으로 만들어 냅니다. 라이더와 레이더, 지도 데이터의 Euclidean Tensor view는 Neural Convolution 엔진이 처리하는 텐서를 쌓아 intermediate Euclidean tensor view features를 생성하며, 궁극적으로는 풍부하고 상세한 3D 정보를 생산하기 위해 Euclidean view에서 detection을 하고자 합니다.
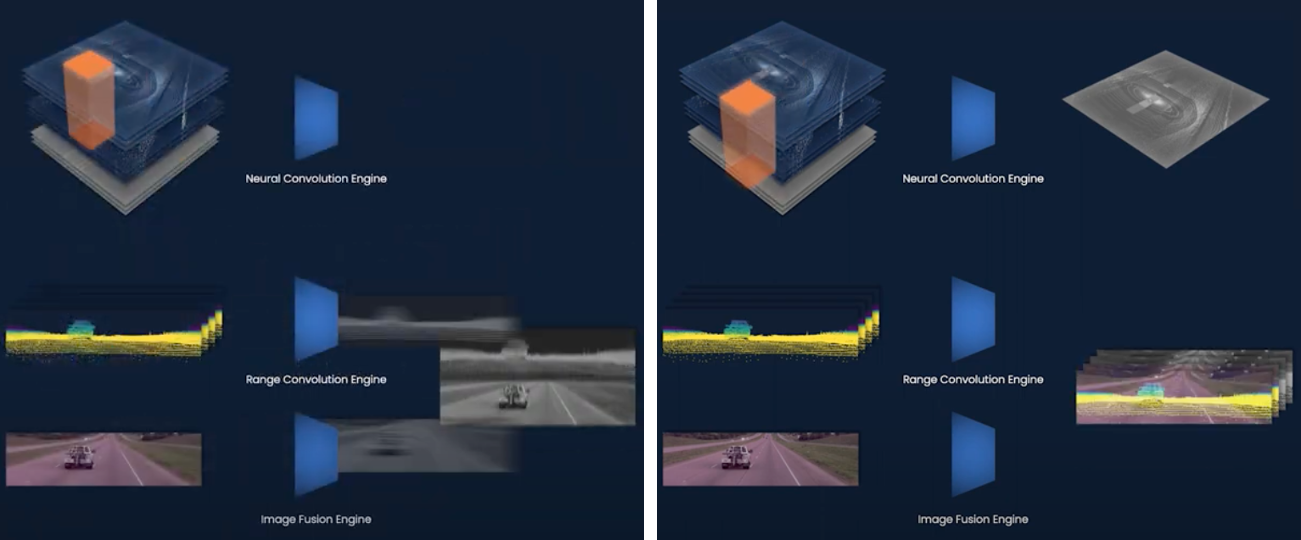
이런 작업은 Euclidean ray caster를 사용하는데, ray scatter 엔진으로 range view 데이터에서 Euclidean 공간의 점들로 변환하게 됩니다. Range view 내의 각 픽셀은 3D 내 점에 정확히 대응하게 됩니다. Range view 내 픽셀에 대응하는 features는 3D 내 위치로 추적한 다음 Euclidean view 내 적절한 cell에 배치가 됩니다.
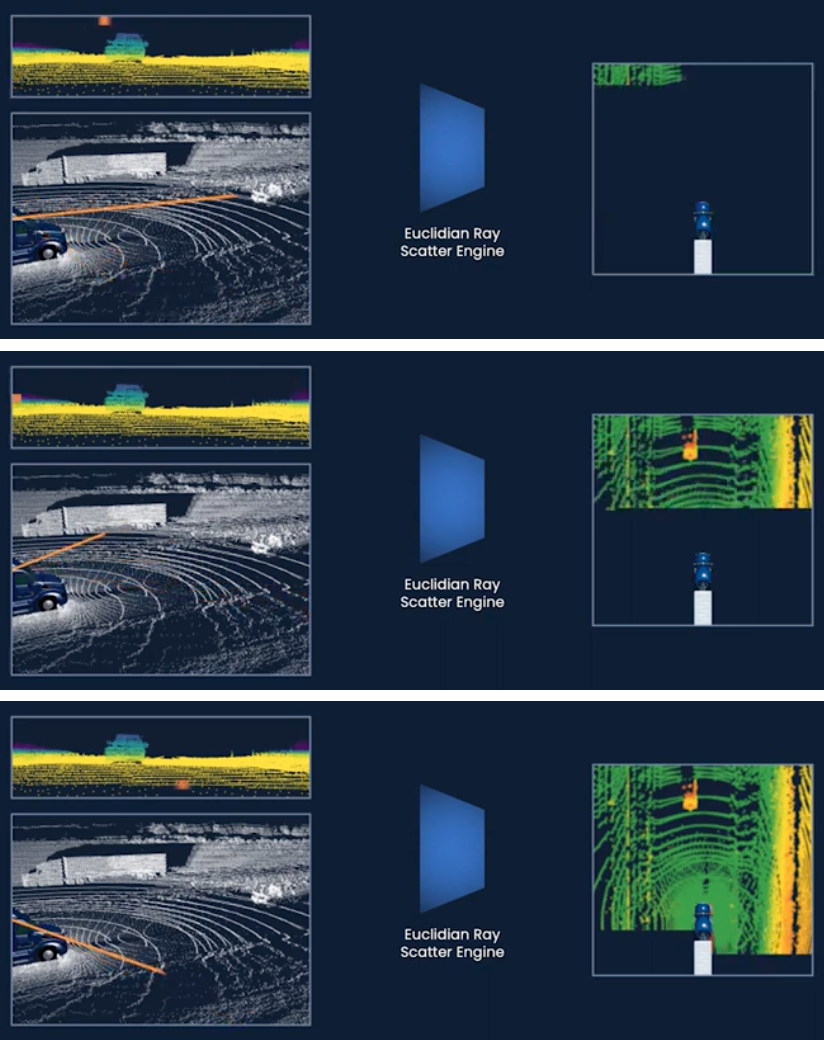
이 프로세스는 Range view 내 각 픽셀에 대해 반복되어 Range 데이터에서 해당 Euclidean Tensor view를 생성합니다. 최종적으로는 Range view에서 갭쳐된 정보를 Euclidean View Tensor 로 이전하게 되는데, Euclidean View Tensor는 다른 센서 모달리티에서 비롯된 다른 Euclidean Feature map과 융합할 수 있기 때문입니다. 이런 점에서 모든 센서 모달리티의 feature maps은 Euclidean tensor view 에 있게 됩니다.
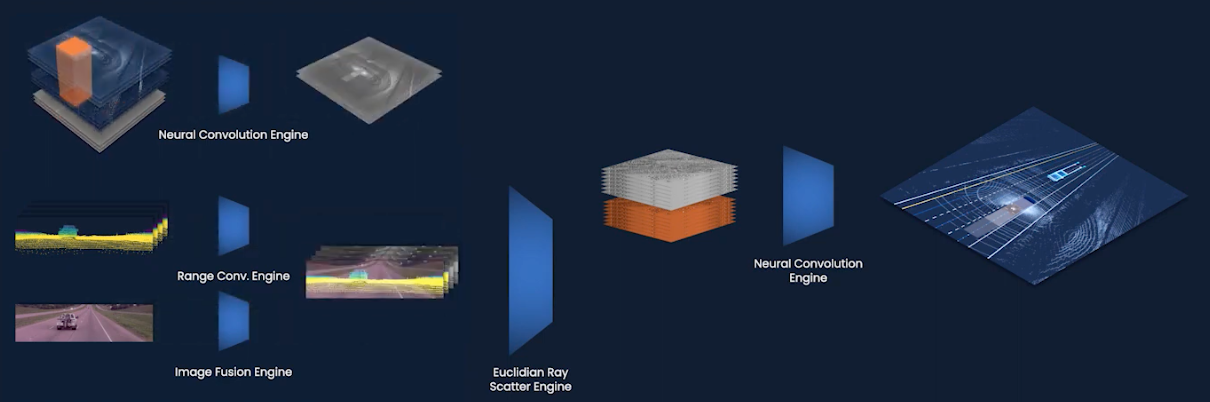
Feature maps들은 모두 함께 쌓을 수 있으며, Neural Convolution 엔진으로 처리하여 고품질의 3D detection을 생성할 수 있습니다. 이런 Detections는 속도, width, height, 길이 카테고리, 각 detection에 대한 위치의 불확실성 등을 포함하는 object의 속성을 포함합니다. 이것은 우리 주변의 world에 대한 다양한 센서 inputs에서 파생된 데이터를 풍부하게 representation을 생성하게 됩니다.
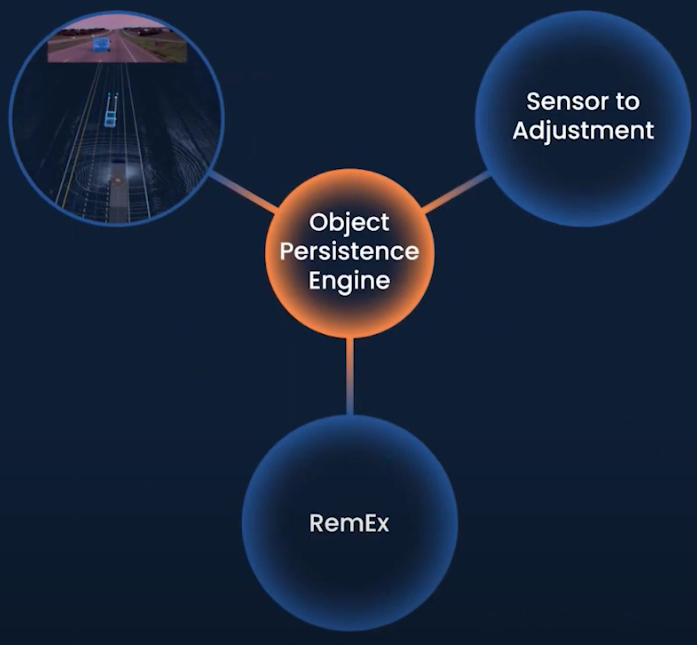
Object persistence 엔진을 통해 2개의 Task 특화된 딥러닝 모듈을 통합하여 도로 내 탐지한 actors를 계속해서 추적할 수 있고, 그들에 대해 추론할 수 있습니다. Perception은 자율 주행 스택에서 하나의 단계이며, 이외에도 여러 모듈이 있습니다.
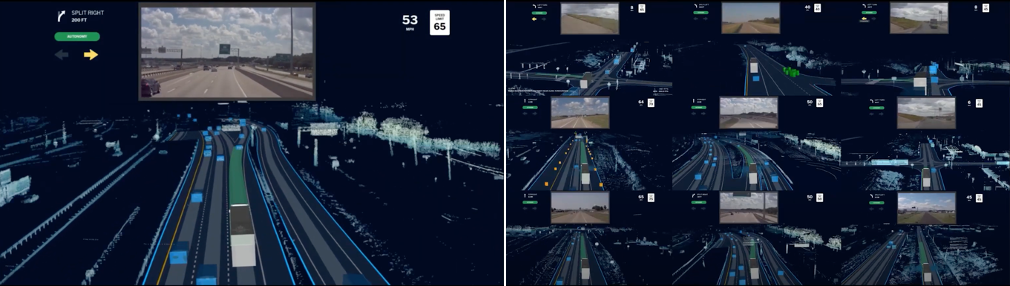
Perception 외 motion planning, ML aided Labeling, Simulation 등도 머신러닝과 딥러닝을 활용합니다. Aurora의 ML 개발 workflow를 위해 차량 로그(Vehicle Logs)를 수집하고 레이블(Labels)과 결합하며, 다양한 팀들에서, 다양한 모델들을 사용하기 위한 통합된 학습 데이터를 생성합니다. 이 값들은 Feature Store에 저장하고, 여기서 시각화(Visualization)와 탐색(Exploration)을 이 가능하게 됩니다.
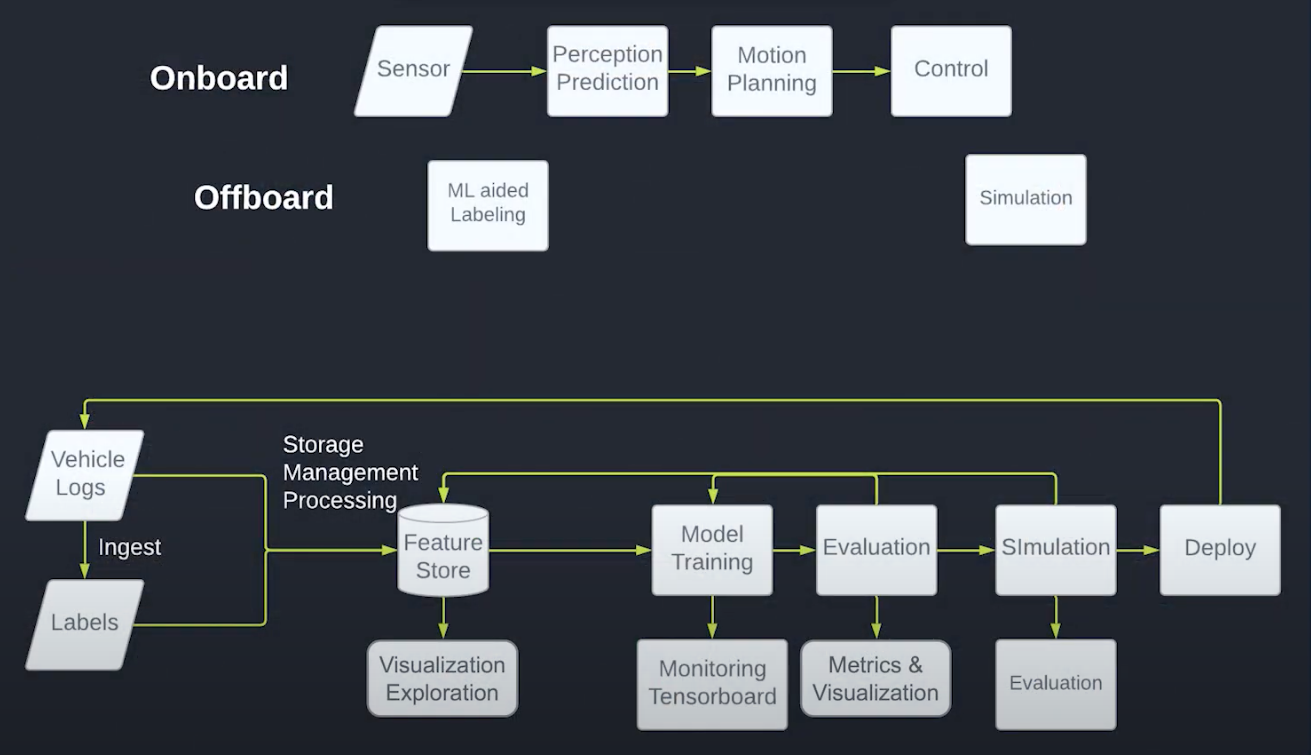
다음 단계로는 학습 데이터를 활용하여 모델을 학습(Model Training)하고 테스트 데이터로 다양한 성능 메트릭을 이용하여 모델의 성능을 측정합니다. 모델과 전체 자율주행 모듈이 정상적으로 동작하는지 확인하기 위해 일련의 검사를 거친 후 모델을 차량에 배포합니다. 이런 단계들은 매우 복잡하고 반복적으로 진행될 수 있는데, 차량으로 모델을 배포하는 타임 라인, 출시 일정, 취급해야하는 다양한 모델, 다양한 데이터 유형, 발전되는 시나리오와 방법 등이 당면하는 어려움들이 됩니다. 이런 이유에서 더욱 빠르게 반복 가능한 ML 개발 사이클이 필요하고, 자율주행 기술 뒤에 있는 모델 개선에 대한 다양한 가설들을 빠르게 실험해 볼 수 있는 large-scale 학습이 필요합니다.
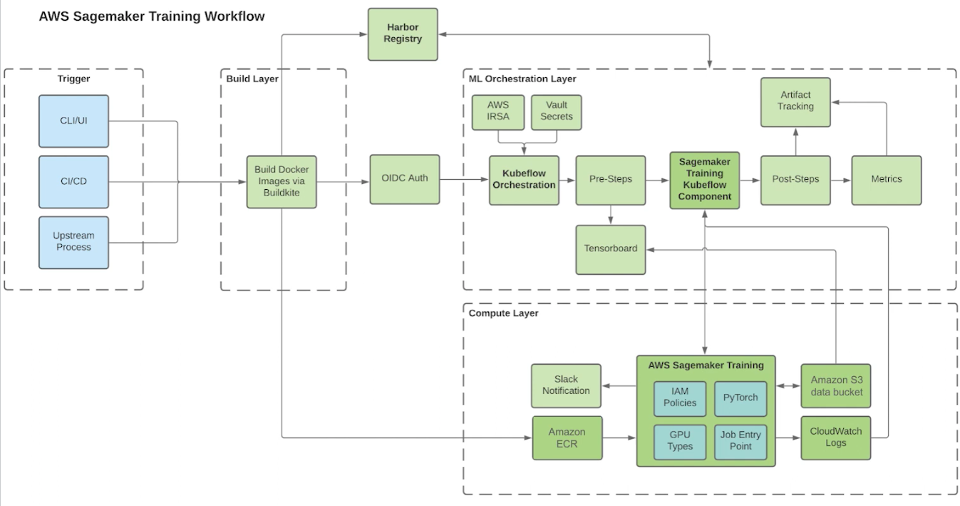
Aurora는 ML 워크플로우를 관리하기 위해 Kubeflow를 사용하는데, use case별로 학습을 시작하는 3가지 방법이 있습니다.
- Command Line이나 UI를 통한 학습 실행
- 주기적인 이슈를 확인하는 계획된 CI/CD 작업에 따른 학습 실행
- 신규 데이터의 확보 등과 같이 upstream 프로세스에 의한 학습이 실행
이러한 트리거들 중 하나를 통해 학습이 시작되면, build, orchestration, compute 3가지 계층에서 작업이 진행됩니다.
- Build - Kubeflow는 모든 단계에 필요한 Container 이미지를 통합하여 파이프라인을 트리거하기 전에 Harbor registry 와 Amazon ECR로 push 하는데, Kubeflow는 AWS IAM role과 같은 표준 authentication 을 지원합니다.
- Orchestration - Kubeflow orchestration 은 SageMaker training Kubeflow component를 사용하여 SageMaker에서 학습을 수행합니다.
- Compute - SageMaker training job에서 필요한 GPU 인스턴스를 확보하고, 분산학습을 수행합니다.
학습이 진행되는 상황은 Amazon CloudWatch와 TensorBoard 등에서 로그에서 확인하거나 로그 기능에서 학습 진행 상황 또는 다른 표준 및 사용자 지정 메트릭을 모니터링할 수 있습니다. 학습 후에는 TensorRT로 export 하는 것과 같은 후처리 단계를 통해 체크포인트 파일을 가져옵니다. Metric Evaluation 단계에서는 테스트 데이터를 이용하여 모델 성능을 검증합니다.

이렇게 학습에서 모델 평가까지 일반적인 ML workflow에 대해 Kubeflow와 SageMaker를 통합해서 사용할 수 있습니다. Kubeflow UI에서 과거 jobs 에 대한 이력을 쉽게 볼 수 있으며, 실험 결과를 비교할 수 있습니다. 입력 파라미터를 비교하여 실험 조건의 어떤 측면이 실행 결과에 영향을 주었는지 확인하고 동일한 Tensorboard에서 시각화 할 수 있습니다.
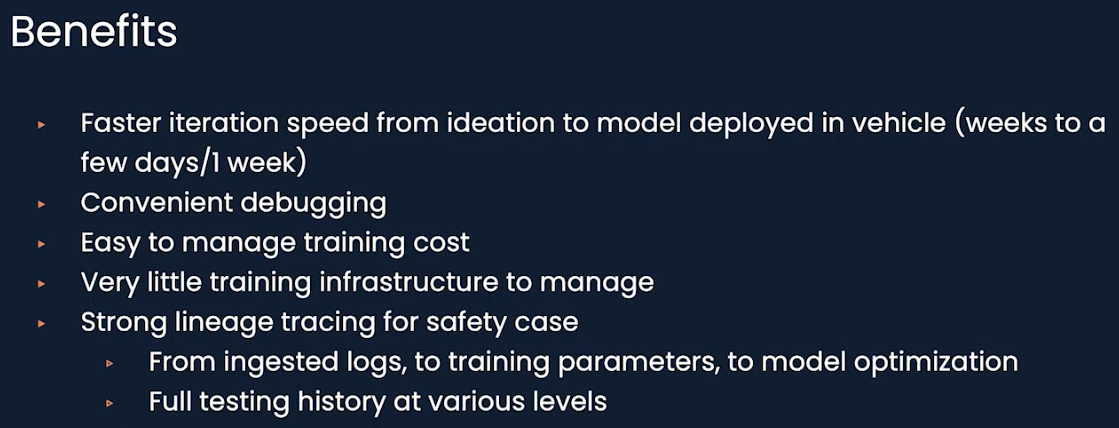
SageMaker를 이용해서 ideation에서 차량에 배포되는 모델까지의 반복적인 일정이 단축되었습니다. 몇주가 걸리던 이런 일들이 이제 며칠에서 일주일로 단축되었습니다. 또한, 입력 파라미터를 검토하고 로그를 확인하는 데 매우 편리합니다. 학습 비용에 대한 관리도 쉬워졌으며, 직접 관리해야 하는 인프라가 많이 줄어들었다는 점도 좋은 장점 중 하나입니다. 다양한 단계별로 수집된 데이터를 이용해서 Kubeflow에서는 이를 통해 실험의 전체적인 lineage를 추적하는 활동이 가능하게 되었습니다.
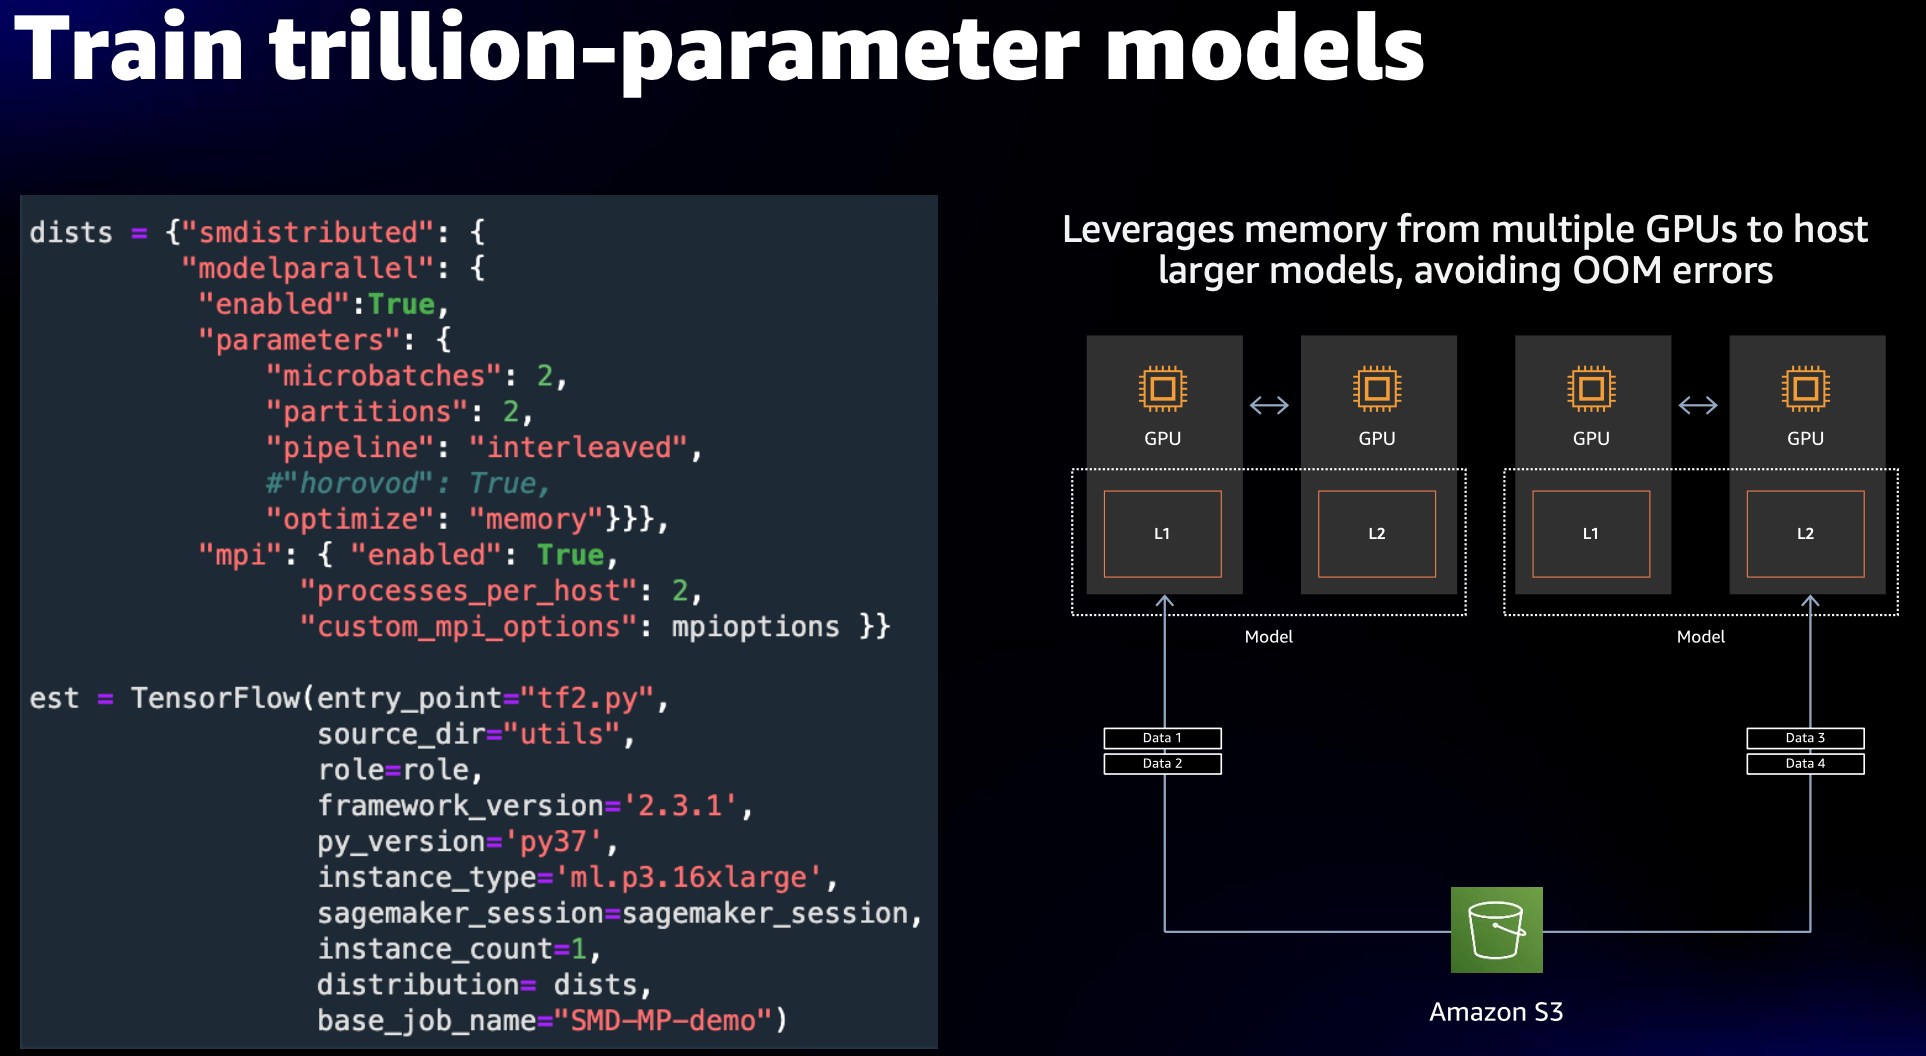
이런 점에서 Amazon SageMaker는 2개의 분산학습 라이브러리를 제공합니다.
모델의 사이즈가 훨등히 큰 모델의 경우 1개의 GPU 리소스에서 모델학습이 어려운 경우가 발생할 수 있습니다. 이런 경우 우리는 Model Parallel library를 이용하여 OOM (Out-Of-Memory)가 발생하는 것을 방지할 수 있습니다. SageMaker는 성능이 우수한 자체 Model Parallel library를 제공하는데, 기존의 학습 코드에서 5~6줄 정도를 변경한다면 SageMaker에서 바로 적용이 가능합니다.
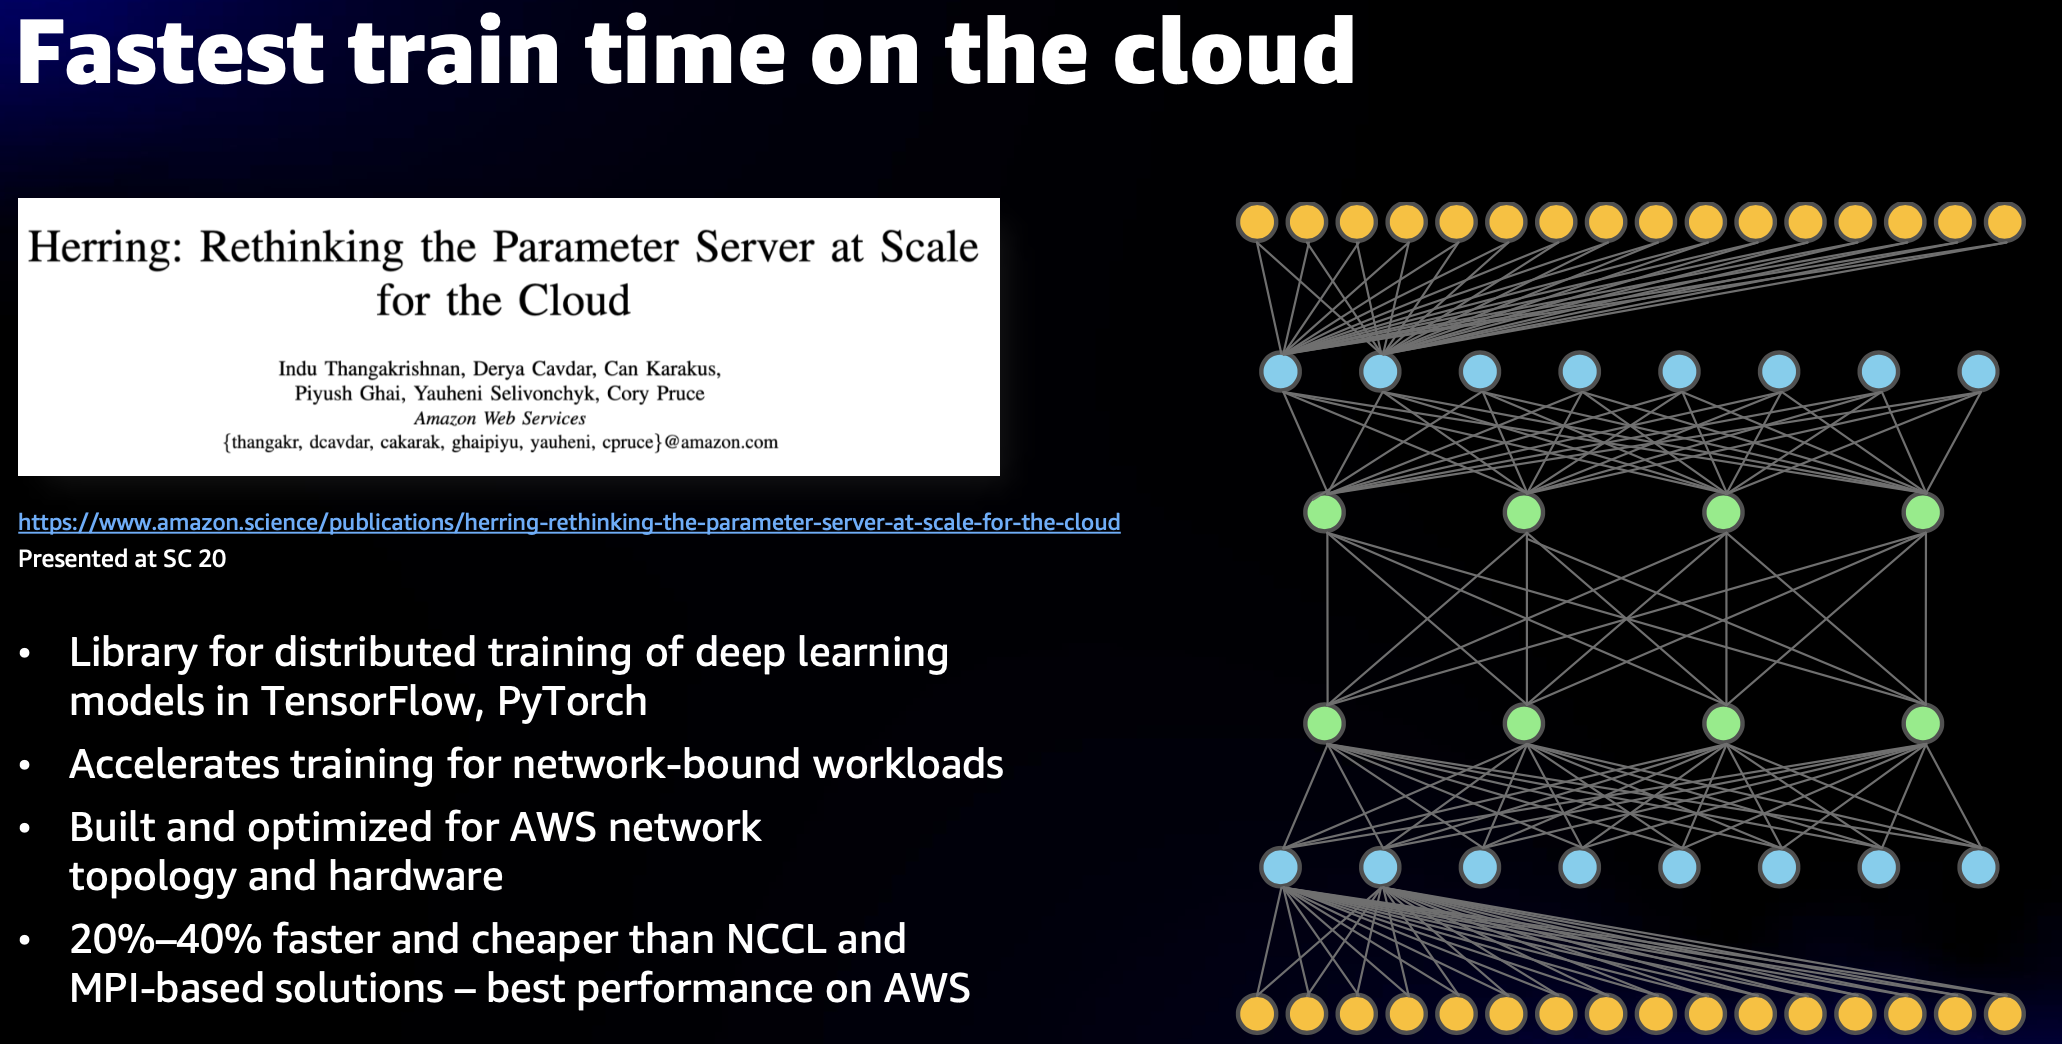
SageMaker에서는 Data Parallel library도 제공합니다. 기존 NCCL을 제거하고 대체하는 새로운 communication protocol을 통해서 NCCL 과 MPI-baed 솔루션인 Horovod 대비 20~40% 속도를 개선하였습니다. 아래는 이와 관련된 논문입니다. 이 library의 경우에도 기존 학습 코드가 DDP가 가능하도록 구현되어 있다면 큰 변경 없이 바로 사용이 가능합니다.